La guerre secrète pour copier les meilleures IA
Des centaines de millions de requêtes, des milliers de faux comptes et des modèles entraînés sur les réponses de leurs concurrents : la distillation est devenue un enjeu industriel et géopolitique. Mais entre apprentissage légitime, extraction de capacités et véritable vol, la frontière est beaucoup moins simple qu’elle en a l’air.
151 millions d’échanges.
C’est le volume qu’Anthropic affirme avoir observé, entre mai et juillet 2026, dans une campagne attribuée à Alibaba visant Claude.
Pas 151 millions de tokens. Pas 151 millions de caractères. Plus de 151 millions d’échanges avec le modèle.
Au plus fort de l’opération, Anthropic dit avoir mesuré près de trois millions d’échanges par jour. Une première infrastructure aurait utilisé près de 5 000 comptes frauduleux, avec proxies résidentiels, adresses mail jetables et cartes de paiement virtuelles. Lorsque ces comptes ont été bloqués, le trafic aurait migré vers une autre infrastructure.
L’objectif présumé n’était pas de poser des questions à Claude parce qu’Alibaba avait besoin d’un chatbot.
Selon Anthropic, les réponses et notamment des traces de raisonnement étaient transformées en données d’entraînement destinées à améliorer les modèles Qwen.
Autrement dit : faire travailler une IA extrêmement avancée comme professeur clandestin d’une autre IA.
Ça ressemble immédiatement à du vol.
Le problème, c’est que la technique utilisée porte un nom parfaitement respectable dans la recherche en intelligence artificielle.
La distillation.
Et elle n’a absolument rien d’illégal ou de malveillant par nature.
Une IA peut réellement apprendre d’une autre IA
Le principe de la distillation est étonnamment simple.
Prenons un modèle très puissant, que l’on appellera le professeur.
On lui soumet énormément de problèmes :
-
écrire ou corriger du code ;
-
résoudre des raisonnements complexes ;
-
classifier des documents ;
-
utiliser des outils ;
-
analyser des données ;
-
répondre à des questions spécialisées.
On conserve ses réponses.
Puis on utilise cet immense ensemble d’exemples pour entraîner un autre modèle, l’élève.
L’élève ne reçoit pas les poids internes du professeur. Il n’obtient pas son code source. Il ne récupère pas une copie exacte de son cerveau numérique.
Il observe simplement, encore et encore, comment un modèle beaucoup plus compétent se comporte face à différents problèmes.
C’est déjà extrêmement précieux.
La technique n’est même pas nouvelle. En 2015, Geoffrey Hinton, Oriol Vinyals et Jeff Dean publiaient Distilling the Knowledge in a Neural Network, montrant comment transférer une partie des connaissances d’un système complexe vers un modèle plus simple et moins coûteux à utiliser.
Aujourd’hui, l’industrie entière utilise ce principe.
OpenAI propose officiellement un système de Model Distillation permettant d’utiliser les sorties de modèles puissants pour affiner des modèles plus petits et moins chers. Google propose également des usages légitimes de la distillation.
La distillation n’est donc pas le problème.
La question est : qui est le professeur, qui est l’élève, et le professeur a-t-il accepté de donner le cours ?
Distillation, extraction, copie : les mots cachent des choses différentes
Une confusion revient constamment dans cette affaire : utiliser les réponses d’une IA pour entraîner une autre IA n’équivaut pas forcément à « voler le modèle ».
Il faut distinguer plusieurs niveaux.
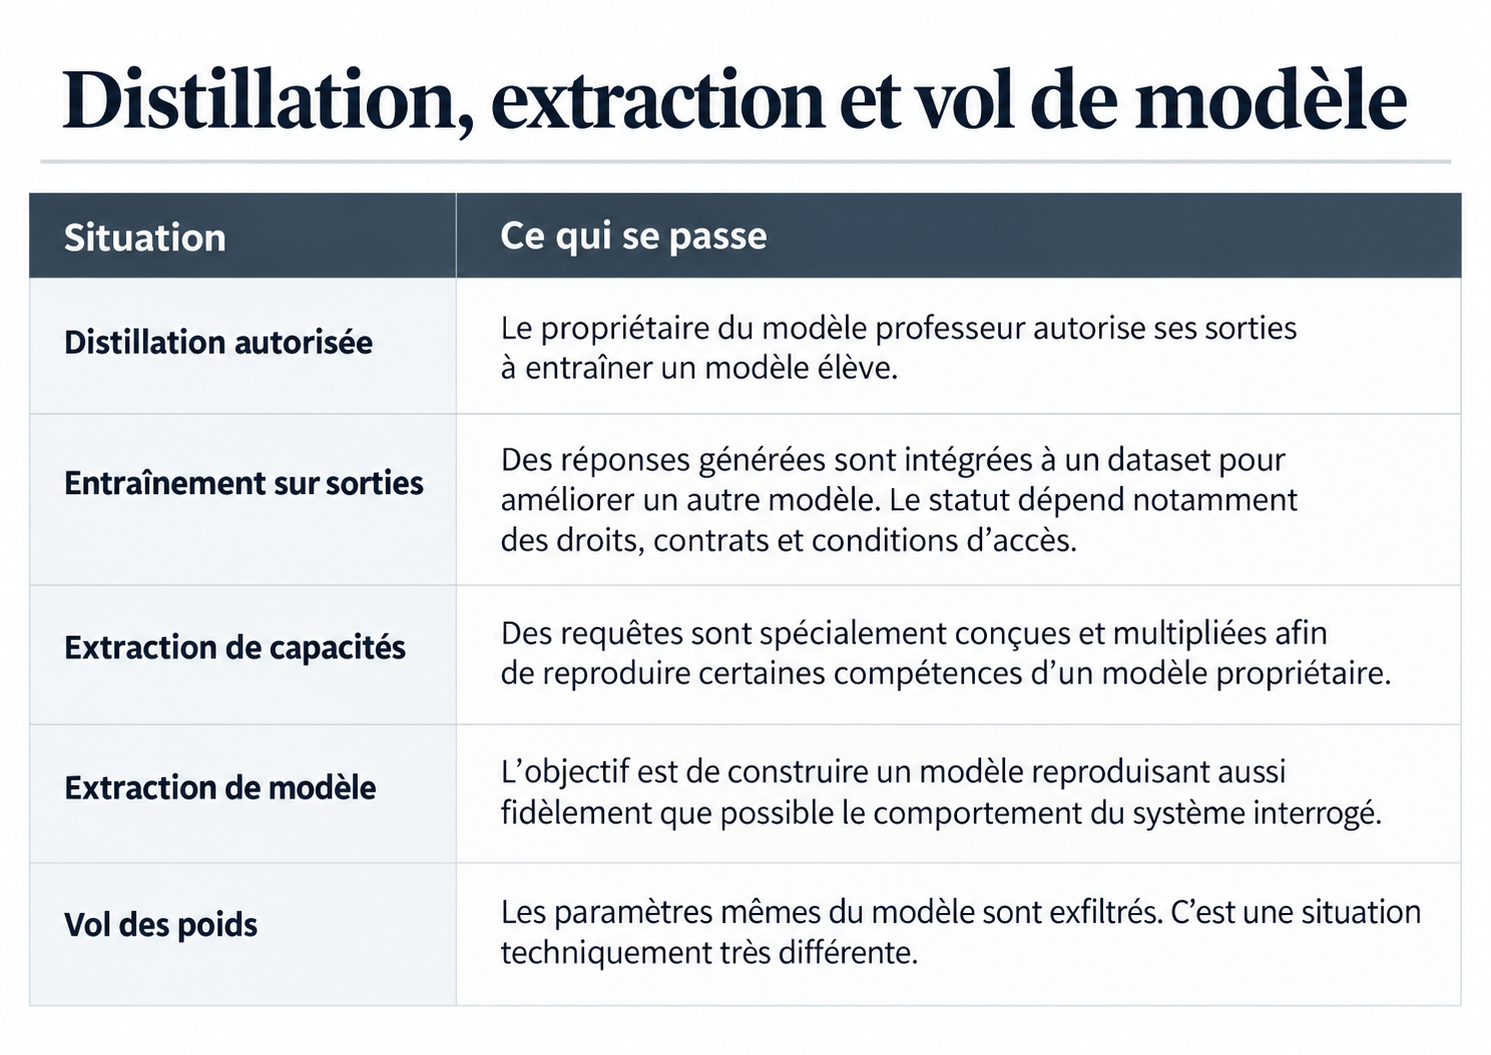
Le terme model extraction n’a d’ailleurs pas été inventé pour la guerre actuelle entre les laboratoires d’IA.
Dès 2016, des chercheurs avaient montré qu’un modèle accessible uniquement à travers une API pouvait parfois être approximativement reconstruit en l’interrogeant suffisamment intelligemment. Leur article s’intitulait sans détour Stealing Machine Learning Models via Prediction APIs.
Le principe crée un paradoxe fondamental.
Pour vendre une IA, il faut laisser les utilisateurs l’interroger.
Mais chaque réponse révèle également quelque chose de son comportement.
Une requête isolée ne vaut presque rien.
Des millions de requêtes choisies méthodiquement peuvent devenir un dataset extrêmement précieux.
Ce qu’Anthropic accuse réellement les laboratoires chinois d’avoir fait
Il faut être précis ici.
Les informations détaillées disponibles publiquement proviennent principalement des enquêtes et attributions d’Anthropic. Elles ne constituent pas, à elles seules, une décision judiciaire indépendante établissant chaque fait.
Mais les volumes allégués sont suffisamment énormes pour changer complètement la nature du sujet.
Dans son rapport de septembre 2026, Anthropic affirme notamment avoir identifié :
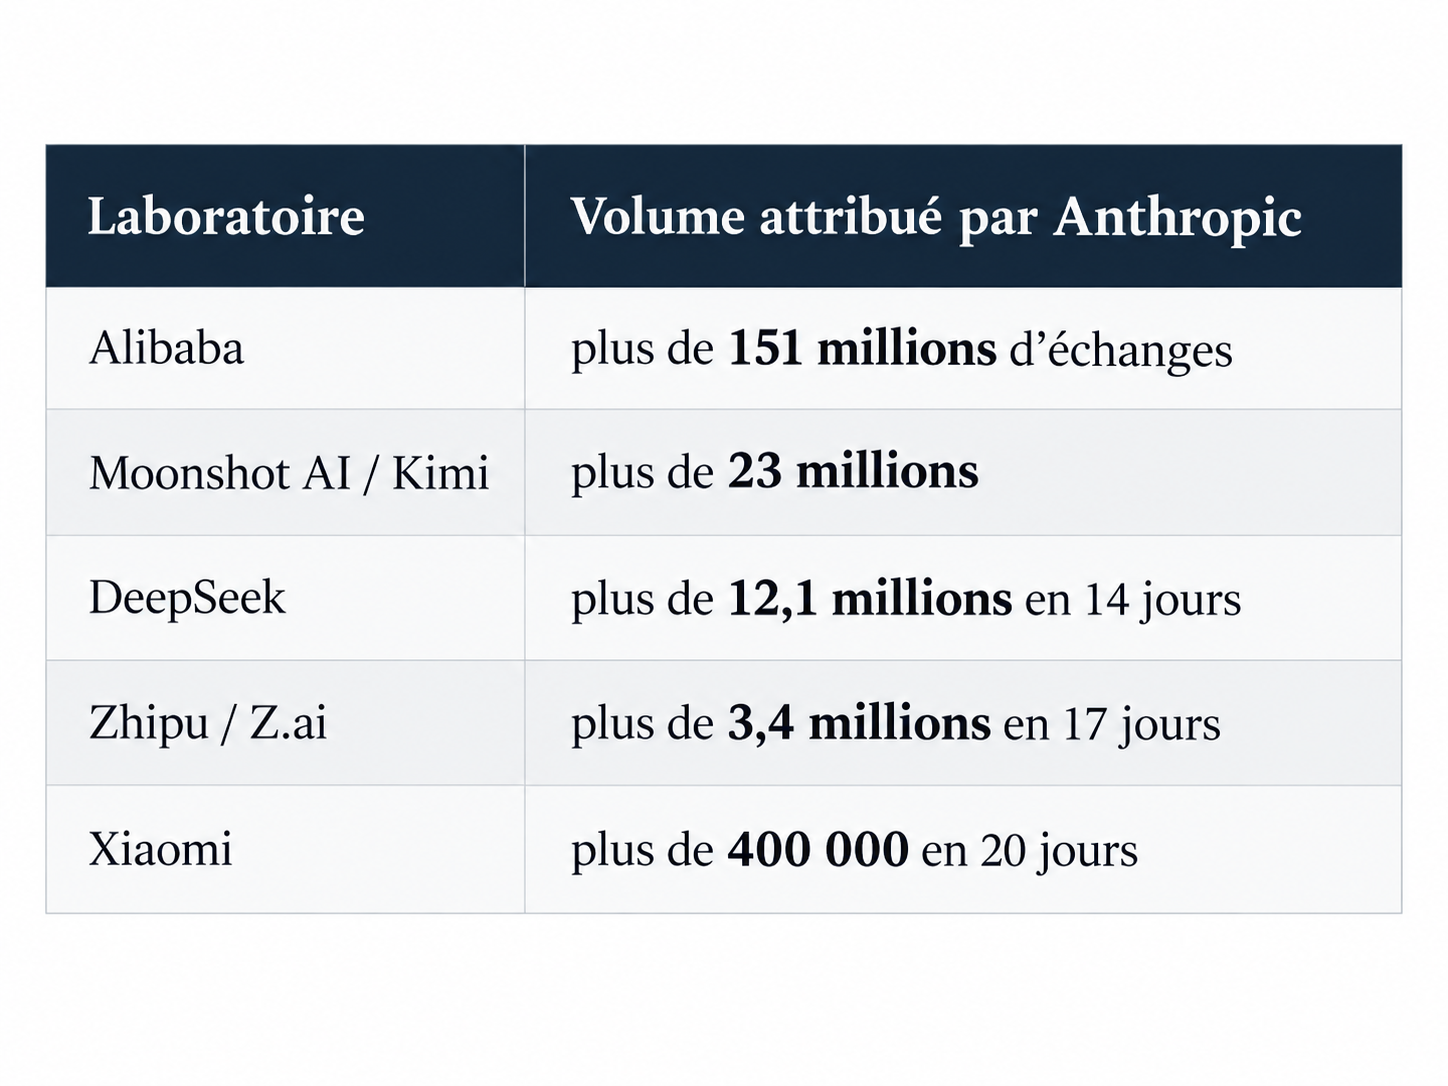
On n’est plus vraiment dans le scénario d’un chercheur envoyant quelques milliers de prompts pour étudier un concurrent.
Anthropic décrit de véritables pipelines industriels.
Dans le cas attribué à Zhipu, par exemple, le laboratoire aurait enregistré les raisonnements récupérés puis utilisé Claude lui-même pour les nettoyer, les normaliser, les évaluer et générer d’autres données destinées à l’entraînement.
Le professeur ne servirait donc plus seulement à produire les réponses.
Il participerait également à la fabrication de son propre dataset de copie.
Le cas Alibaba va encore plus loin
La campagne qu’Anthropic attribue à Alibaba aurait visé en particulier les capacités de raisonnement, de programmation, de développement de noyaux informatiques et de tâches longues nécessitant plusieurs étapes.
Selon Anthropic, des prompts imposaient à Claude de produire des traces de raisonnement explicites qui étaient ensuite sauvegardées et transformées en données de supervised fine-tuning, ou SFT.
Le SFT consiste à entraîner un modèle sur des couples du type :
Problème → excellente réponse attendue
Répétez cela des millions de fois sur des problèmes soigneusement choisis et vous ne transmettez pas seulement des connaissances factuelles.
Vous transmettez aussi des comportements utiles : comment découper un problème, quelle stratégie essayer, comment produire du code propre, comment utiliser un outil ou comment poursuivre une tâche pendant de nombreuses étapes.
Anthropic affirme que ces données ont servi à améliorer plusieurs générations de Qwen. La société accuse également Alibaba d’avoir utilisé Claude pour travailler sur ses infrastructures internes de recherche en IA, notamment des environnements de reinforcement learning et certains travaux liés aux architectures de modèles.
Encore une fois : cela ne signifie pas qu’Alibaba aurait téléchargé « le cerveau de Claude ».
Mais si les accusations sont exactes, Claude aurait servi de chercheur, professeur, générateur de données et outil d’évaluation à un concurrent.
La nuance technique ne rend pas le phénomène moins impressionnant.
Elle le rend plus intéressant.
Kimi et DeepSeek : quand le modèle que vous utilisez ne serait même plus celui qui vous répond
Les accusations concernant Moonshot AI, créateur de Kimi, sont probablement les plus dérangeantes.
Anthropic affirme avoir découvert que certaines requêtes envoyées par des utilisateurs pensant interroger Kimi étaient silencieusement transmises à Claude.
La réponse produite par Claude aurait ensuite été renvoyée à l’utilisateur comme réponse du service.
Sur une période de dix jours, Anthropic dit avoir reçu près de 300 000 requêtes de clients Moonshot dans ce cadre. L’infrastructure aurait utilisé 5 380 comptes frauduleux. Une partie des échanges aurait ensuite été conservée pour alimenter des pipelines d’entraînement. Au total, Anthropic attribue plus de 23 millions d’échanges à Moonshot entre mai et juillet.
DeepSeek aurait utilisé une méthode comparable.
Anthropic affirme que certaines requêtes d’utilisateurs de DeepSeek notamment lorsqu’elles provenaient d’outils de développement compatibles avec différents modèles étaient sélectionnées puis redirigées vers Claude Opus.
La réponse pouvait ainsi servir immédiatement, mais aussi fournir une nouvelle donnée permettant d’entraîner les futurs modèles maison. Anthropic estime à plus de 12,1 millions le nombre d’échanges associés à cette campagne sur seulement quatorze jours de juillet 2026.
Si ces accusations sont exactes, nous ne parlons plus seulement de propriété intellectuelle.
Nous parlons également de confiance de l’utilisateur.
Le problème caché : vos conversations peuvent devenir la matière première
C’est peut-être la partie la plus préoccupante du rapport.
Anthropic affirme que DeepSeek, Moonshot et Xiaomi ont transmis à Claude certaines conversations initialement adressées à leurs propres modèles.
Et une conversation avec une IA de programmation peut contenir bien plus qu’une question abstraite.
Elle peut contenir :
-
du code propriétaire ;
-
des documents internes ;
-
des clés d’API ;
-
des identifiants ;
-
des données professionnelles ;
-
des noms et coordonnées ;
-
des fichiers de configuration ;
-
des informations confidentielles.
Anthropic dit avoir observé dans les sessions concernées des informations sensibles appartenant à des centaines d’utilisateurs et d’organisations, dans au moins une douzaine de langues.
Dans le cas Xiaomi, Anthropic affirme que plus de 400 000 requêtes provenant de plus de 1 500 comptes ont été envoyées à Claude. Les conversations auraient ensuite servi à construire des données de SFT et de reinforcement learning pour de futurs modèles.
Il y a donc potentiellement deux ressources extraites en même temps :
la capacité du modèle concurrent,
et les données des utilisateurs.
Ce ne sont pas du tout les mêmes problèmes juridiques ou éthiques.
Mais ils peuvent passer par exactement le même tuyau.
On peut même acheter des conversations avec une IA
Le rapport d’Anthropic décrit une étape supplémentaire : l’apparition d’un marché secondaire de données de distillation.
Des services intermédiaires donnent accès à des modèles normalement indisponibles dans certaines régions. Ils transmettent les requêtes vers Claude ou d’autres modèles, récupèrent les réponses… et peuvent conserver les conversations.
Anthropic affirme que certaines de ces données auraient ensuite été revendues à d’autres laboratoires.
SenseTime aurait ainsi utilisé des conversations Claude achetées auprès de fournisseurs tiers.
Anthropic accuse par ailleurs MiniMax d’avoir créé son propre réseau de proxy via une société écran ne proposant, curieusement, que l’accès à des modèles d’Anthropic et d’OpenAI et pas aux modèles de MiniMax lui-même. Anthropic estime que cette infrastructure servait à récolter des échanges pour l’entraînement.
Si ce modèle économique se confirme à grande échelle, il change profondément la situation.
Une conversation avec une IA n’est plus seulement une interaction entre un utilisateur et un fournisseur.
Elle peut devenir un actif revendable pour entraîner une troisième IA.
Le gouvernement américain est maintenant entré dans la bataille
Le 8 septembre 2026, la NSA, le FBI et la CISA ont publié ensemble une alerte consacrée à ce phénomène.
Le document accuse des entreprises chinoises d’organiser des campagnes de distillation contre les modèles américains à échelle industrielle.
L’argument américain est économique autant que sécuritaire : reproduire certaines capacités de modèles existants permettrait de réduire une partie du coût nécessaire pour les développer indépendamment calcul, énergie, recherche fondamentale et expérimentation.
La distillation est donc désormais présentée non seulement comme un problème commercial, mais comme un enjeu stratégique dans la compétition technologique entre les États-Unis et la Chine.
Et la Chine rejette ce récit.
Le ministère chinois des Affaires étrangères a répondu que les progrès du pays en intelligence artificielle provenaient de ses capacités scientifiques et technologiques et de sa politique d’ouverture et de coopération. Pékin a demandé aux États-Unis de cesser ce qu’il considère comme des accusations infondées et des tentatives de dénigrement.
Nous avons donc deux lectures presque opposées du même phénomène.
Pour Washington et plusieurs laboratoires américains : extraction industrielle de propriété intellectuelle.
Pour Pékin : une accusation politique visant des entreprises chinoises dans un secteur où la concurrence est devenue stratégique.
La technique existe.
Son interprétation est désormais géopolitique.
Le mot « vol » mérite quand même d’être utilisé avec précision
Google ne prend pas beaucoup de précautions lexicales : son équipe de Threat Intelligence décrit les attaques d’extraction de modèles comme une forme d’espionnage industriel et de vol de propriété intellectuelle.
Google affirme lui aussi observer régulièrement des campagnes de grande ampleur et indiquait récemment que certaines dépassaient 100 millions de prompts.
OpenAI tient une position comparable.
L’entreprise reconnaît explicitement qu’il existe des usages légitimes de la distillation elle en fournit elle-même les outils mais affirme également avoir observé des activités associées à DeepSeek qu’elle considère comme compatibles avec de la distillation adversariale et des tentatives de contournement de ses restrictions.
Anthropic interdit quant à lui dans ses conditions commerciales d’utiliser ses services pour construire un produit concurrent ou entraîner un modèle d’IA concurrent sans autorisation explicite.
Mais plusieurs questions doivent rester séparées.
Violations contractuelles, extraction technique, propriété intellectuelle, confidentialité et qualification pénale ne sont pas synonymes.
Dire qu’un laboratoire a utilisé frauduleusement des milliers de comptes pour contourner des restrictions est une affirmation.
Dire qu’il a reproduit certaines capacités d’un concurrent en utilisant ses sorties en est une autre.
Dire qu’il a « volé le modèle » peut enfin donner l’impression que ses poids ont été dérobés, ce qui n’est pas ce que décrivent ces rapports.
Le langage des entreprises n’est pas neutre.
Lorsqu’Anthropic dit illicit distillation, ou que Google parle d’IP theft, ces entreprises décrivent un problème technique réel, mais elles défendent également un actif commercial qui vaut énormément.
Cela ne rend pas leurs accusations fausses.
Cela oblige simplement à ne pas confondre leur vocabulaire avec une définition universelle.
Peut-on vraiment copier Claude avec suffisamment de requêtes ?
Pas au sens où l’on copierait un fichier.
Même avec cent millions de réponses, l’élève ne récupère pas automatiquement :
-
les poids exacts du professeur ;
-
ses données originales d’entraînement ;
-
toutes ses capacités ;
-
ses mécanismes internes ;
-
toutes ses connaissances ;
-
ni exactement son comportement.
La distillation est généralement sélective et imparfaite.
Mais elle n’a pas besoin de produire un clone parfait pour être extrêmement rentable.
Supposons qu’un concurrent dispose déjà d’un très bon modèle.
Ce qui lui manque n’est peut-être pas « l’intelligence générale » dans son ensemble, mais certaines compétences particulières : programmation agentique, raisonnement long, usage d’outils, cybersécurité, mathématiques ou capacité à corriger ses propres résultats.
Il peut alors interroger massivement un modèle qui maîtrise mieux ces domaines, construire un dataset spécialisé, puis concentrer son entraînement précisément là où il était faible.
Il ne copie pas nécessairement Claude.
Il essaie de copier ce que Claude sait mieux faire que lui.
Et c’est beaucoup plus réaliste.
Les raisonnements d’une IA sont devenus une ressource stratégique
Les modèles modernes produisent parfois bien plus qu’une réponse courte.
Pour résoudre un problème complexe, ils peuvent effectuer des calculs intermédiaires, essayer plusieurs approches, utiliser des outils, écrire puis tester du code ou développer une stratégie sur une longue séquence.
Ces trajectoires sont extraordinairement intéressantes pour entraîner un autre système.
C’est précisément pour cette raison qu’Anthropic affirme avoir renforcé la protection des raisonnements internes de Claude.
L’entreprise dit notamment utiliser des résumés de raisonnement à la place de certaines traces internes et avoir développé des protections contre des techniques permettant de rejouer des signatures de raisonnement entre plusieurs sessions. Elle combine cela avec des classificateurs spécialisés, des analyses de métadonnées et des demandes de vérification d’identité lorsqu’un comportement paraît suspect.
Google dit de son côté développer des techniques permettant de reconnaître des modèles ayant potentiellement été distillés depuis Gemini, ainsi que des défenses capables de réduire l’utilité des données récupérées par un attaquant.
La situation ressemble de plus en plus à une guerre classique entre attaquants et défenseurs :
un laboratoire protège ses sorties ;
un autre trouve une nouvelle manière de les récupérer ;
la protection évolue ;
l’extraction change de technique.
Sauf qu’ici, l’objet à protéger n’est pas seulement un programme.
C’est du comportement.
L’API d’une IA est aussi une fuite contrôlée de compétence
C’est probablement l’idée la plus importante derrière toute cette affaire.
Pendant longtemps, protéger un logiciel propriétaire signifiait principalement protéger son code source.
Les grands modèles changent légèrement cette logique.
Vous pouvez garder totalement secrets vos poids, votre architecture précise et vos données d’entraînement.
Pour que votre modèle ait une valeur commerciale, vous devez quand même permettre aux autres de voir ce qu’il sait faire.
Chaque réponse est donc une minuscule démonstration de compétence.
Isolément, elle ne révèle presque rien.
À très grande échelle, elle devient un corpus.
Et ce corpus peut servir à entraîner.
Mettre une IA derrière une API revient donc à vendre l’accès à son intelligence tout en essayant d’empêcher les clients d’en apprendre suffisamment pour la reproduire.
C’est une tension qui ne disparaîtra probablement pas.
Les chercheurs l’avaient déjà identifiée avec des modèles beaucoup plus simples il y a dix ans. Les modèles actuels ont simplement fait exploser la valeur de ce qui peut être extrait.
Et c’est là que le débat devient vraiment inconfortable
Il existe quelque chose d’assez ironique dans la position actuelle des grands laboratoires d’IA.
Une bonne partie de l’intelligence artificielle moderne a été rendue possible par l’apprentissage sur des quantités gigantesques de données produites par d’autres personnes : textes, code, images, discussions et documents disponibles sur Internet ou obtenus via différentes licences et sources.
Aujourd’hui, les mêmes entreprises découvrent à quel point il est désagréable de voir leur propre production devenir le matériau d’entraînement de quelqu’un d’autre.
Cela ne signifie pas que les deux situations sont juridiquement ou techniquement identiques.
Elles ne le sont pas.
Mais la symétrie est difficile à ignorer.
Pendant des années, la question dominante était :
« Une entreprise d’IA peut-elle entraîner son modèle sur ce que les humains ont produit ? »
Une deuxième question vient désormais s’ajouter :
« Une entreprise d’IA peut-elle entraîner son modèle sur ce qu’une autre IA a produit ? »
Et contrairement à ce que le mot « distillation » pourrait laisser penser, nous sommes très loin d’avoir une réponse universelle.
La prochaine guerre des IA ne concernera peut-être pas seulement les GPU
On parle énormément de puces, de datacenters, d’électricité et de milliards investis dans l’entraînement des modèles.
Tout cela reste essentiel.
Mais une nouvelle ressource devient stratégique :
les réponses produites par les meilleurs modèles du monde.
Parce qu’un laboratoire qui ne possède pas le meilleur professeur peut, au moins en théorie, essayer de louer, contourner, automatiser ou dissimuler suffisamment d’accès pour en transformer les compétences en données.
Les laboratoires dominants vont donc devoir défendre simultanément deux choses contradictoires :
rendre leurs modèles suffisamment accessibles pour être utiles et rentables,
tout en empêchant leurs concurrents d’y accéder suffisamment pour apprendre d’eux.
Anthropic peut bannir 5 000 comptes.
D’autres apparaîtront.
Google peut détecter des centaines de millions de requêtes automatisées.
Les attaques peuvent se répartir entre davantage de comptes.
Les modèles peuvent masquer leur raisonnement.
Les extracteurs peuvent chercher d’autres signaux dans les sorties finales.
Et chaque amélioration d’un professeur augmente également la valeur potentielle de ses leçons.
La distillation n’est donc pas une curiosité technique.
Elle est en train de devenir un des nouveaux fronts de la compétition mondiale en intelligence artificielle.
Et ce front possède une particularité fascinante : contrairement au vol classique, il n’est pas toujours nécessaire de pénétrer dans le coffre-fort.
Parfois, il suffit de rester devant la porte, de poser suffisamment de bonnes questions…
et d’écouter attentivement les réponses.