Der geheime Krieg um das Kopieren der besten KI
Hunderte Millionen Anfragen, Tausende Fake-Accounts und Modelle, die auf den Antworten ihrer Konkurrenten trainiert wurden: Destillation ist zu einem industriellen und geopolitischen Thema geworden. Doch die Grenze zwischen legitimen Lernen, Fähigkeitsextraktion und echtem Diebstahl ist viel weniger klar, als es scheint.
151 Millionen Austausche.
Das ist das Volumen, das Anthropic eigenen Angaben zufolge zwischen Mai und Juli 2026 in einer Kampagne beobachtet haben will, die Alibaba zugeschrieben wird und die sich gegen Claude richtete.
Nicht 151 Millionen Tokens. Nicht 151 Millionen Zeichen. Mehr als 151 Millionen Austausche mit dem Modell.
Auf dem Höhepunkt der Operation soll Anthropic knapp drei Millionen Austausche pro Tag gemessen haben. Eine erste Infrastruktur soll knapp 5 000 betrügerische Accounts genutzt haben, mit Residential Proxies, Wegwerf-E-Mail-Adressen und virtuellen Zahlungskarten. Als diese Accounts gesperrt wurden, soll der Traffic auf eine andere Infrastruktur migriert sein.
Das mutmaßliche Ziel war nicht, Claude Fragen zu stellen, weil Alibaba einen Chatbot brauchte.
Laut Anthropic wurden die Antworten – und insbesondere Spuren des Reasonings – in Trainingsdaten umgewandelt, um die Qwen-Modelle zu verbessern.
Anders ausgedrückt: Eine extrem fortschrittliche KI als heimlichen Lehrer einer anderen KI arbeiten lassen.
Das sieht sofort nach Diebstahl aus.
Das Problem: Die verwendete Technik trägt in der KI-Forschung einen absolut seriösen Namen.
Destillation.
Und sie ist von Natur aus weder illegal noch bösartig.
Eine KI kann tatsächlich von einer anderen KI lernen
Das Prinzip der Destillation ist überraschend einfach.
Nehmen wir ein sehr mächtiges Modell, das wir den Lehrer nennen.
Wir unterbreiten ihm massenhaft Probleme:
-
Code schreiben oder korrigieren;
-
komplexe Reasonings lösen;
-
Dokumente klassifizieren;
-
Tools nutzen;
-
Daten analysieren;
-
Fachfragen beantworten.
Wir behalten seine Antworten.
Dann nutzen wir diese riesige Beispielsammlung, um ein anderes Modell, den Schüler, zu trainieren.
Der Schüler erhält nicht die internen Gewichte des Lehrers. Er bekommt nicht dessen Quellcode. Er erhält keine exakte Kopie seines digitalen Gehirns.
Er beobachtet einfach, immer und immer wieder, wie ein weit kompetenteres Modell sich bei unterschiedlichen Problemen verhält.
Das ist bereits extrem wertvoll.
Die Technik ist nicht einmal neu. 2015 veröffentlichten Geoffrey Hinton, Oriol Vinyals und Jeff Dean Distilling the Knowledge in a Neural Network und zeigten, wie sich Teile des Wissens eines komplexen Systems auf ein einfacheres, günstiger nutzbares Modell übertragen lassen.
Heute nutzt die gesamte Industrie dieses Prinzip.
OpenAI bietet offiziell ein Model Distillation-System an, das die Ausgaben mächtiger Modelle nutzt, um kleinere, billigere Modelle zu verfeinern. Google bietet ebenfalls legitime Anwendungen der Destillation an.
Destillation ist also nicht das Problem.
Die Frage lautet: Wer ist der Lehrer, wer ist der Schüler – und hat der Lehrer zugestimmt, den Unterricht zu geben?
Destillation, Extraktion, Kopie: Die Wörter verbergen Unterschiedliches
Eine Verwirrung zieht sich durch diese ganze Affäre: Die Antworten einer KI für das Training einer anderen KI zu nutzen, heißt nicht unbedingt, „das Modell zu stehlen“.
Man muss mehrere Ebenen unterscheiden.
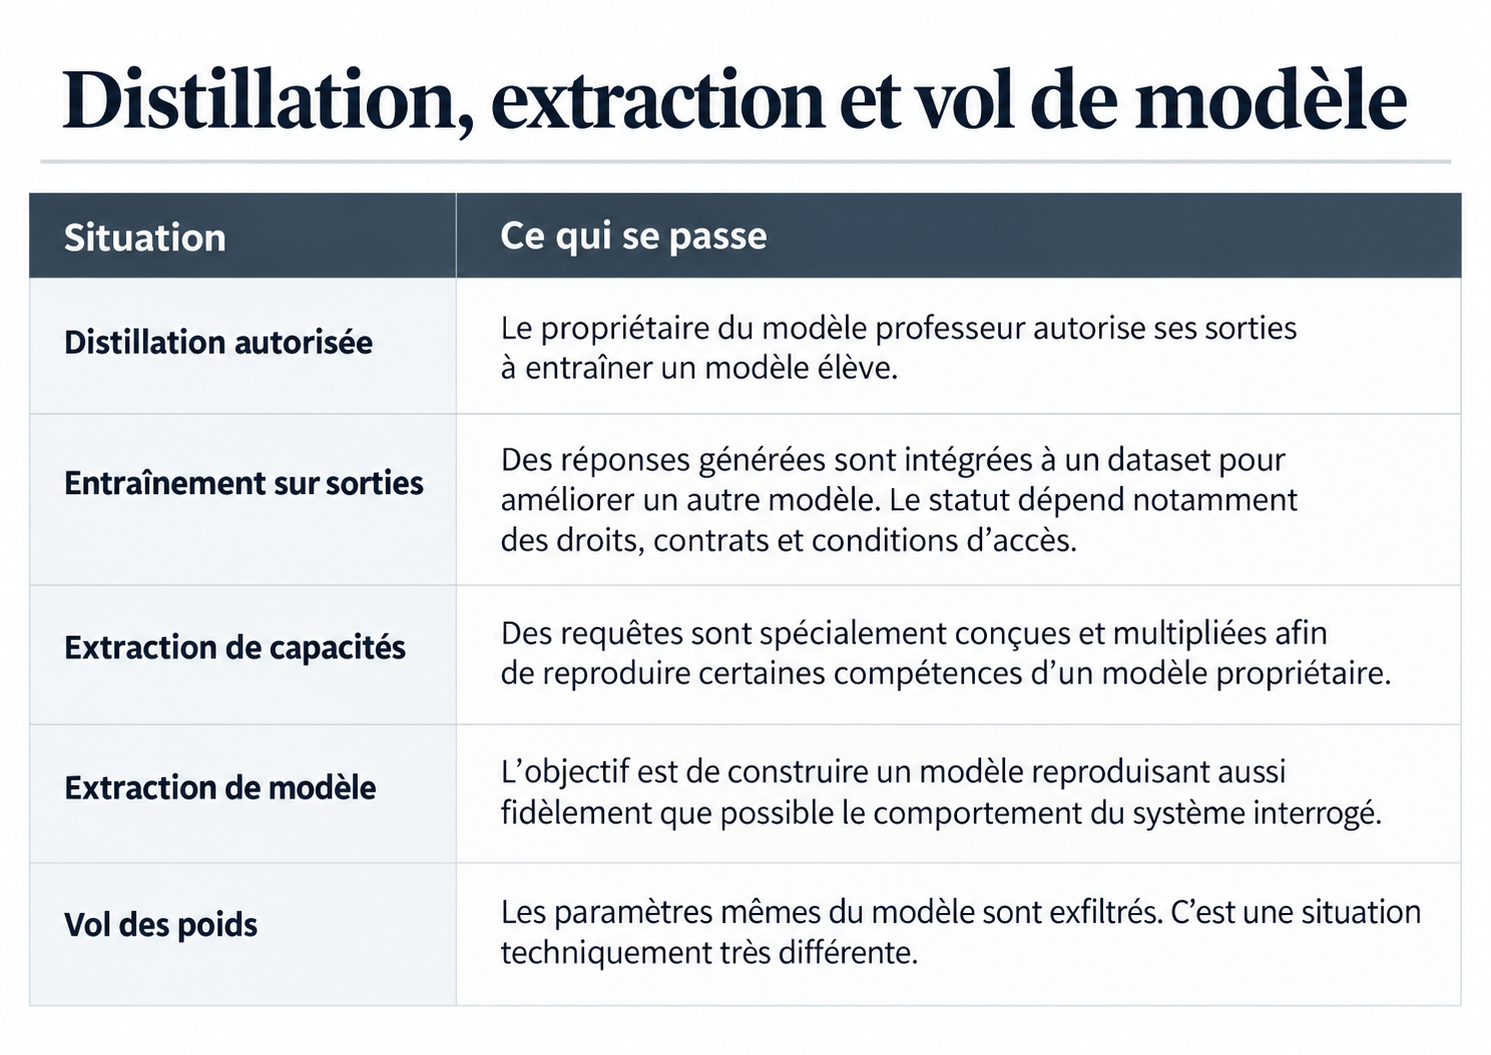
Der Begriff model extraction wurde übrigens nicht für den aktuellen Krieg zwischen den KI-Laboren erfunden.
Schon 2016 hatten Forscher gezeigt, dass ein Modell, das nur über eine API zugänglich ist, manchmal approximativ rekonstruiert werden kann, wenn man es ausreichend clever abfragt. Ihr Paper trug den unverblümten Titel Stealing Machine Learning Models via Prediction APIs.
Das Prinzip erzeugt ein fundamentales Paradoxon.
Um eine KI zu verkaufen, muss man Nutzern erlauben, sie abzufragen.
Aber jede Antwort verrät auch etwas über ihr Verhalten.
Eine einzelne Anfrage ist fast wertlos.
Millionen methodisch gewählter Anfragen können zu einem extrem wertvollen Datensatz werden.
Was Anthropic chinesischen Laboren tatsächlich vorwirft
Hier muss man präzise sein.
Die detailliert öffentlich verfügbaren Informationen stammen hauptsächlich aus Anthropics Untersuchungen und Zuschreibungen. Sie allein stellen keine unabhängige gerichtliche Entscheidung dar, die jeden Fakt feststellt.
Aber die beanstandeten Volumen sind groß genug, um die Natur des Themas komplett zu verändern.
In seinem Bericht vom September 2026 behauptet Anthropic unter anderem, Folgendes identifiziert zu haben:
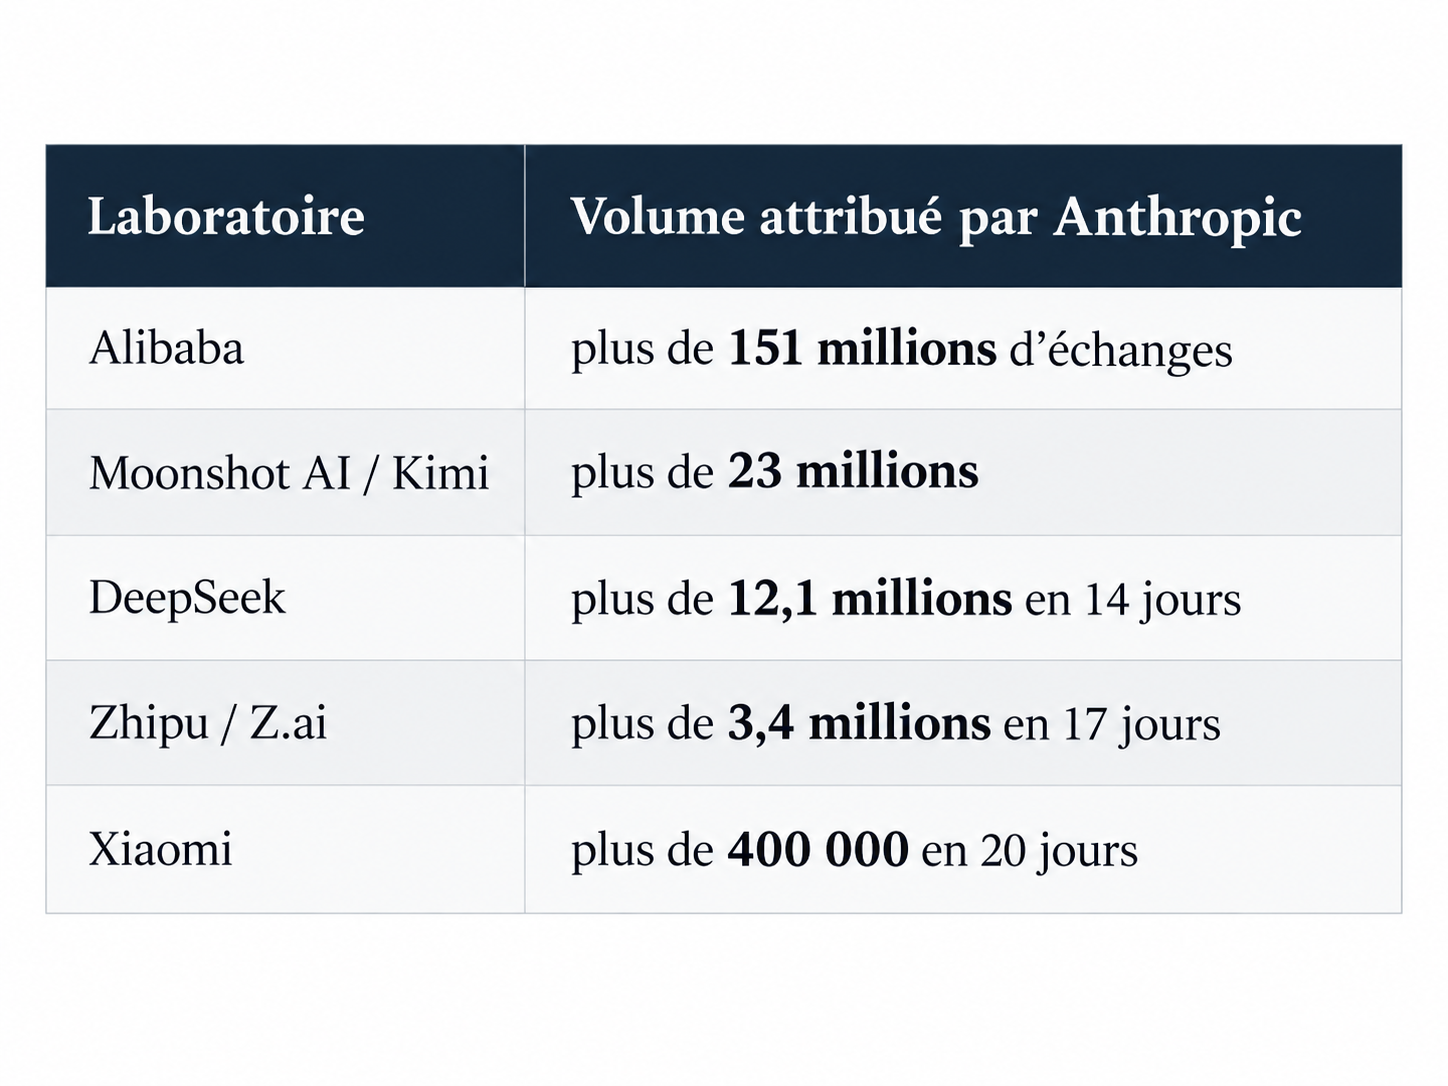
Man ist nicht mehr wirklich in dem Szenario eines Forschers, der ein paar tausend Prompts schickt, um einen Konkurrenten zu studieren.
Anthropic beschreibt echte industrielle Pipelines.
Im Fall, der Zhipu zugeschrieben wird, soll das Labor die abgerufenen Reasonings aufgezeichnet und dann Claude selbst genutzt haben, um sie zu bereinigen, zu normalisieren, zu bewerten und weitere fürs Training bestimmte Daten zu generieren.
Der Lehrer würde also nicht mehr nur die Antworten liefern.
Er würde auch an der Herstellung seines eigenen Kopier-Datensatzes mitwirken.
Der Fall Alibaba geht noch weiter
Die Kampagne, die Anthropic Alibaba zuschreibt, soll insbesondere die Reasoning-, Programmierungs-, Kernel-Entwicklungs- und Long-Horizon-Aufgaben mit mehreren Schritten angegriffen haben.
Laut Anthropic zwangen Prompts Claude, explizite Reasoning-Spuren zu produzieren, die dann gespeichert und in Supervised Fine-Tuning-Daten, also SFT, umgewandelt wurden.
SFT besteht darin, ein Modell auf Paare der Art zu trainieren:
Problème → excellente réponse attendue
Wiederholt man das millionenfach bei sorgfältig gewählten Problemen, überträgt man nicht nur faktisches Wissen.
Man überträgt auch nützliche Verhaltensweisen: Wie man ein Problem zerlegt, welche Strategie man versucht, wie man sauberen Code produziert, wie man ein Tool nutzt oder wie man eine Aufgabe über viele Schritte verfolgt.
Anthropic behauptet, diese Daten hätten mehrere Generationen von Qwen verbessert. Der Konzern wirft Alibaba zudem vor, Claude für die interne KI-Forschungsinfrastruktur genutzt zu haben, namentlich Reinforcement-Learning-Umgebungen und bestimmte Arbeiten zu Modellarchitekturen.
Noch einmal: Das bedeutet nicht, dass Alibaba „Clayudes Gehirn“ heruntergeladen hätte.
Aber wenn die Vorwürfe stimmen, hätte Claude als Forscher, Lehrer, Datengenerator und Evaluierungstool für einen Konkurrenten gedient.
Die technische Nuance macht das Phänomen nicht weniger beeindruckend.
Sie macht es interessanter.
Kimi und DeepSeek: Wenn das Modell, das du nutzt, gar nicht mehr das ist, das dir antwortet
Die Vorwürfe gegen Moonshot AI, den Schöpfer von Kimi, sind wohl die beunruhigendsten.
Anthropic behauptet, entdeckt zu haben, dass bestimmte Anfragen, die Nutzer an Kimi zu richten glaubten, stillschweigend an Claude weitergeleitet wurden.
Die von Claude erzeugte Antwort sei dann als Antwort des Dienstes an den Nutzer zurückgeschickt worden.
Über einen Zeitraum von zehn Tagen habe Anthropic in diesem Rahmen knapp 300 000 Anfragen von Moonshot-Kunden erhalten. Die Infrastruktur soll 5 380 betrügerische Accounts genutzt haben. Ein Teil der Austausche sei anschließend behalten worden, um Trainingspipelines zu füttern. Insgesamt schreibt Anthropic Moonshot zwischen Mai und Juli mehr als 23 Millionen Austausche zu.
DeepSeek soll eine vergleichbare Methode genutzt haben.
Anthropic behauptet, bestimmte Anfragen von DeepSeek-Nutzern – insbesondere wenn sie von Entwicklungstools stammten, die mit verschiedenen Modellen kompatibel sind – seien ausgewählt und an Claude Opus umgeleitet worden.
Die Antwort konnte so nicht nur sofort dienen, sondern auch neue Daten für das Training künftiger Hausmodelle liefern. Anthropic schätzt die dieser Kampagne zugeordneten Austausche auf mehr als 12,1 Millionen in nur vierzehn Tagen im Juli 2026.
Wenn diese Vorwürfe stimmen, reden wir nicht mehr nur über geistiges Eigentum.
Wir reden auch über Nutzervertrauen.
Das versteckte Problem: Ihre Gespräche können zum Rohstoff werden
Das ist vielleicht der besorgniserregendste Teil des Berichts.
Anthropic behauptet, DeepSeek, Moonshot und Xiaomi hätten bestimmte Gespräche, die ursprünglich an ihre eigenen Modelle gerichtet waren, an Claude weitergeleitet.
Und ein Gespräch mit einer Programmier-KI kann weit mehr enthalten als eine abstrakte Frage.
Es kann enthalten:
-
proprietären Code;
-
interne Dokumente;
-
API-Schlüssel;
-
Zugangsdaten;
-
berufliche Daten;
-
Namen und Kontaktdaten;
-
Konfigurationsdateien;
-
vertrauliche Informationen.
Anthropic gibt an, in den betreffenden Sitzungen sensible Informationen von Hunderten Nutzern und Organisationen in mindestens einem Dutzend Sprachen beobachtet zu haben.
Im Fall Xiaomi behauptet Anthropic, mehr als 400 000 Anfragen von über 1 500 Accounts seien an Claude geschickt worden. Die Gespräche hätten anschließend dem Aufbau von SFT- und Reinforcement-Learning-Daten für künftige Modelle gedient.
Es werden also potenziell zwei Ressourcen gleichzeitig extrahiert:
die Fähigkeit des Konkurrenzmodells,
und die Nutzerdaten.
Das sind überhaupt nicht dieselben juristischen oder ethischen Probleme.
Aber sie können durch genau dieselbe Leitung fließen.
Man kann sogar Gespräche mit einer KI kaufen
Anthropics Bericht beschreibt einen weiteren Schritt: das Entstehen eines Sekundärmarkts für Destillationsdaten.
Intermediäre Dienste verschaffen Zugang zu Modellen, die in bestimmten Regionen normalerweise nicht verfügbar sind. Sie leiten Anfragen an Claude oder andere Modelle weiter, holen die Antworten ab … und können die Gespräche aufbewahren.
Anthropic behauptet, einige dieser Daten seien anschließend an andere Labore weiterverkauft worden.
SenseTime soll so Claude-Gespräche genutzt haben, die von Drittanbietern gekauft wurden.
Anthropic wirft zudem MiniMax vor, ein eigenes Proxy-Netzwerk über eine Scheinfirma aufgebaut zu haben, die kurioserweise nur Zugang zu Modellen von Anthropic und OpenAI anbot, nicht zu denen von MiniMax selbst. Anthropic schätzt, diese Infrastruktur diente dem Einsammeln von Austauschen fürs Training.
Wenn sich dieses Wirtschaftsmodell im großen Maßstab bestätigt, verändert es die Lage grundlegend.
Ein Gespräch mit einer KI ist nicht mehr nur eine Interaktion zwischen Nutzer und Anbieter.
Es kann zu einem weiterverkäuflichen Asset werden, um eine dritte KI zu trainieren.
Die US-Regierung ist jetzt in den Kampf eingetreten
Am 8. September 2026 veröffentlichten NSA, FBI und CISA gemeinsam eine Warnung zu diesem Phänomen.
Das Dokument wirft chinesischen Unternehmen vor, Destillationskampagnen gegen US-Modelle in industriellem Maßstab zu organisieren.
Das US-Argument ist ökonomisch wie sicherheitspolitisch: Das Nachbauen bestimmter Fähigkeiten bestehender Modelle erlaubte, einen Teil der Kosten einzusparen, die für eine unabhängige Entwicklung nötig sind – Rechenleistung, Energie, Grundlagenforschung und Experimente.
Destillation wird also nicht mehr nur als kommerzielles Problem dargestellt, sondern als strategische Frage im technologischen Wettkampf zwischen den USA und China.
Und China weist diese Erzählung zurück.
Das chinesische Außenministerium antwortete, die Fortschritte des Landes in der KI stammten aus den eigenen wissenschaftlich-technologischen Fähigkeiten und der Politik der Offenheit und Kooperation. Peking forderte die USA auf, das zu unterlassen, was es als haltlose Vorwürfe und Diffamierungsversuche betrachtet.
Wir haben also zwei fast gegensätzliche Lesarten desselben Phänomens.
Für Washington und mehrere US-Labore: industrielle Extraktion geistigen Eigentums.
Für Peking: eine politische Anschuldigung gegen chinesische Unternehmen in einem Sektor, wo der Wettbewerb strategisch geworden ist.
Die Technik existiert.
Ihre Deutung ist nun geopolitisch.
Das Wort „Diebstahl“ verdient trotzdem präzisen Gebrauch
Google macht wenig lexikalische Vorsicht: Sein Threat-Intelligence-Team beschreibt Model-Extraction-Angriffe als Form von Industriespionage und Diebstahl geistigen Eigentums.
Google gibt auch an, regelmäßig Kampagnen großen Ausmaßes zu beobachten, und erklärte jüngst, einige überschritten 100 Millionen Prompts.
OpenAI vertritt eine vergleichbare Position.
Das Unternehmen räumt ausdrücklich ein, dass es legitime Destillationsnutzungen gibt – es stellt dafür selbst Werkzeuge bereit – behauptet aber auch, Aktivitäten beobachtet zu haben, die mit DeepSeek in Verbindung stehen und die es als kompatibel mit adversarialer Destillation und Umgehungsversuchen seiner Restriktionen betrachtet.
Anthropic verbietet in seinen Geschäftsbedingungen hingegen, seine Dienste zum Bau eines Konkurrenzprodukts oder zum Training eines konkurrierenden KI-Modells ohne ausdrückliche Genehmigung zu nutzen.
Aber mehrere Fragen müssen getrennt bleiben.
Vertragsverletzungen, technische Extraktion, geistiges Eigentum, Vertraulichkeit und strafrechtliche Qualifikation sind keine Synonyme.
Zu sagen, ein Labor habe betrügerisch Tausende Accounts genutzt, um Restriktionen zu umgehen, ist eine Behauptung.
Zu sagen, es habe bestimmte Fähigkeiten eines Konkurrenten durch Nutzung dessen Ausgaben nachgebaut, ist eine andere.
Zu sagen, es habe „das Modell gestohlen“, kann schließlich den Eindruck erwecken, seine Gewichte seien gestohlen worden, was diese Berichte nicht beschreiben.
Die Sprache der Unternehmen ist nicht neutral.
Wenn Anthropic von illicit distillation spricht oder Google von IP theft, beschreiben diese Unternehmen ein reales technisches Problem, verteidigen aber auch ein kommerzielles Asset von enormem Wert.
Das macht ihre Vorwürfe nicht falsch.
Es verpflichtet nur dazu, ihren Wortschatz nicht mit einer universellen Definition zu verwechseln.
Kann man Claude wirklich kopieren, wenn man genug Anfragen stellt?
Nicht in dem Sinne, in dem man eine Datei kopiert.
Selbst mit hundert Millionen Antworten erhält der Schüler nicht automatisch:
-
die exakten Gewichte des Lehrers;
-
dessen ursprüngliche Trainingsdaten;
-
alle seine Fähigkeiten;
-
seine internen Mechanismen;
-
sein gesamtes Wissen;
-
noch exakt sein Verhalten.
Destillation ist im Allgemeinen selektiv und unvollkommen.
Aber sie muss keinen perfekten Klon produzieren, um extrem rentabel zu sein.
Angenommen, ein Konkurrent verfügt bereits über ein sehr gutes Modell.
Was ihm fehlt, ist vielleicht nicht die „allgemeine Intelligenz“ als Ganzes, sondern bestimmte spezifische Kompetenzen: agentisches Programmieren, langes Reasoning, Tool-Nutzung, Cybersicherheit, Mathematik oder die Fähigkeit, die eigenen Ergebnisse zu korrigieren.
Er kann dann ein Modell, das diese Bereiche besser beherrscht, massiv abfragen, einen spezialisierten Datensatz bauen und sein Training genau dort konzentrieren, wo er schwach war.
Er kopiert nicht notwendigerweise Claude.
Er versucht zu kopieren, was Claude besser kann als er.
Und das ist viel realistischer.
Die Reasonings einer KI sind zur strategischen Ressource geworden
Moderne Modelle produzieren manchmal weit mehr als eine kurze Antwort.
Um ein komplexes Problem zu lösen, können sie Zwischenschritte rechnen, mehrere Ansätze versuchen, Tools nutzen, Code schreiben und testen oder eine Strategie über eine lange Sequenz entwickeln.
Diese Trajektorien sind für das Training eines anderen Systems außerordentlich interessant.
Genau deshalb behauptet Anthropic, den Schutz der internen Reasonings von Claude verstärkt zu haben.
Das Unternehmen gibt an, unter anderem Reasoning-Zusammenfassungen anstelle bestimmter interner Spuren zu nutzen und Schutzmechanismen gegen Techniken entwickelt zu haben, die Reasoning-Signaturen zwischen mehreren Sessions wiedergeben lassen. Das wird kombiniert mit spezialisierten Klassifizierern, Metadaten-Analysen und Identitätsverifikationsanfragen, wenn ein Verhalten verdächtig erscheint.
Google seinerseits gibt an, Techniken zu entwickeln, um Modelle zu erkennen, die potenziell aus Gemini destilliert wurden, sowie Abwehrmaßnahmen, die den Nutzen der von einem Angreifer abgerufenen Daten reduzieren können.
Die Lage ähnelt zunehmend einem klassischen Wettlauf zwischen Angreifern und Verteidigern:
ein Labor schützt seine Ausgaben;
ein anderes findet einen neuen Weg, sie abzugreifen;
die Schutzmaßnahme entwickelt sich weiter;
die Extraktion ändert die Technik.
Nur dass hier das zu schützende Objekt nicht nur ein Programm ist.
Es ist Verhalten.
Die API einer KI ist auch ein kontrolliertes Leck von Kompetenz
Das ist wahrscheinlich die wichtigste Idee hinter dieser ganzen Affäre.
Lange Zeit hieß proprietäre Software schützen vor allem: Quellcode schützen.
Große Modelle verschieben diese Logik leicht.
Man kann seine Gewichte, seine präzise Architektur und seine Trainingsdaten völlig geheim halten.
Damit das Modell aber kommerziellen Wert hat, muss man anderen trotzdem erlauben zu sehen, was es kann.
Jede Antwort ist also eine winzige Kompetenzdemonstration.
Isoliert verrät sie fast nichts.
In sehr großem Maßstab wird sie zu einem Korpus.
Und dieser Korpus kann zum Trainieren dienen.
Eine KI hinter eine API zu stellen heißt also, Zugang zu ihrer Intelligenz zu verkaufen, während man versucht zu verhindern, dass Kunden genug davon lernen, um sie nachzubauen.
Das ist eine Spannung, die wahrscheinlich nicht verschwinden wird.
Forscher hatten sie schon vor zehn Jahren bei viel einfacheren Modellen identifiziert. Die aktuellen Modelle haben den Wert dessen, was extrahiert werden kann, einfach explodieren lassen.
Und genau hier wird die Debatte wirklich unbequem
In der aktuellen Position der großen KI-Labore steckt eine gewisse Ironie.
Ein Gutteil der modernen KI wurde ermöglicht durch Training auf riesigen Datenmengen, die von anderen Menschen produziert wurden: Texte, Code, Bilder, Diskussionen und Dokumente, die im Internet verfügbar waren oder über verschiedene Lizenzen und Quellen bezogen wurden.
Heute entdecken dieselben Unternehmen, wie unangenehm es ist, die eigene Produktion als Trainingsmaterial für jemand anderen zu sehen.
Das bedeutet nicht, dass die beiden Situationen juristisch oder technisch identisch sind.
Sie sind es nicht.
Aber die Symmetrie ist schwer zu ignorieren.
Jahrelang war die dominante Frage:
„Darf ein KI-Unternehmen sein Modell auf dem trainieren, was Menschen produziert haben?“
Eine zweite Frage kommt jetzt hinzu:
„Darf ein KI-Unternehmen sein Modell auf dem trainieren, was eine andere KI produziert hat?“
Und entgegen dem, was das Wort „Destillation“ suggerieren mag, sind wir von einer universellen Antwort weit entfernt.
Der nächste KI-Krieg wird vielleicht nicht nur um GPUs geführt
Man spricht enorm viel über Chips, Rechenzentren, Strom und investierte Milliarden fürs Modelltraining.
All das bleibt essenziell.
Aber eine neue Ressource wird strategisch:
die Antworten, die die besten Modelle der Welt produzieren.
Weil ein Labor, das nicht den besten Lehrer besitzt, theoretisch versuchen kann, genug Zugang zu mieten, zu umgehen, zu automatisieren oder zu verschleiern, um dessen Kompetenzen in Daten umzuwandeln.
Die dominanten Labore müssen also gleichzeitig zwei widersprüchliche Dinge verteidigen:
ihre Modelle zugänglich genug zu machen, um nützlich und rentabel zu sein,
während sie Konkurrenten daran hindern, genug Zugang zu erhalten, um von ihnen zu lernen.
Anthropic kann 5 000 Accounts sperren.
Andere werden auftauchen.
Google kann hunderte Millionen automatisierter Anfragen detektieren.
Die Angriffe können sich auf mehr Accounts verteilen.
Modelle können ihr Reasoning verbergen.
Extraktoren können nach anderen Signalen in den finalen Ausgaben suchen.
Und jede Verbesserung eines Lehrers erhöht auch den potenziellen Wert seiner Lektionen.
Destillation ist also keine technische Kuriosität.
Sie wird zu einer der neuen Fronten im weltweiten KI-Wettbewerb.
Und diese Front hat eine faszinierende Besonderheit: Im Gegensatz zum klassischen Diebstahl muss man nicht immer in den Tresor eindringen.
Manchmal reicht es, vor der Tür zu bleiben, genug gute Fragen zu stellen …
und den Antworten aufmerksam zuzuhören.