Elon Musk dit que Grok 5 sera une AGI. Encore faut-il pouvoir le prouver
Elon Musk place désormais l’intelligence artificielle générale à Grok 5, alors que Grok 4.7 n’est même pas sorti. Le problème n’est pas seulement de savoir s’il a raison : personne ne s’accorde encore sur le test qui permettrait de le démontrer.
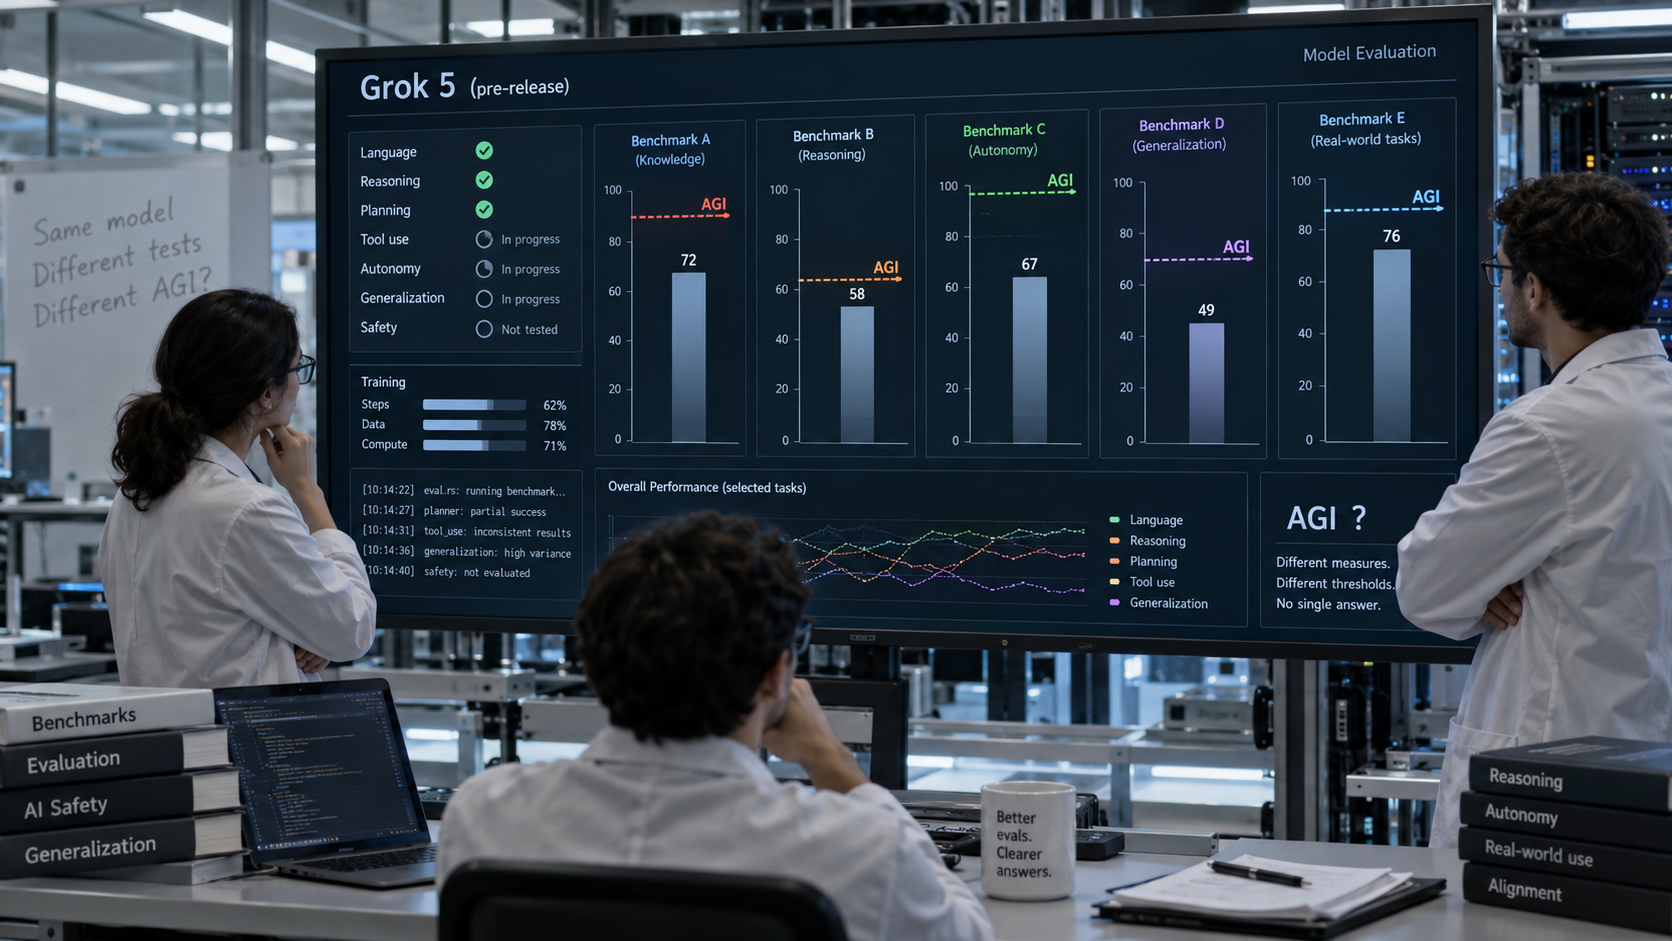
Le 14 septembre 2026, quelqu’un demande à Elon Musk à quel point Grok 4.8 se rapprochera de l’intelligence artificielle générale.
Sa réponse tient en cinq mots :
« That will be Grok 5. »
Quelques minutes plus tard, Musk déroule une étrange échelle : Grok 4.7 serait approximativement au niveau d’Opus 5.0, Grok 4.8 apporterait une amélioration notable, Grok 4.9 atteindrait selon lui la classe d’Astra ou Fable et Grok 5 pourrait être « meilleur que tout ».
Le problème n’est pas que cette prédiction soit forcément fausse.
Le problème est beaucoup plus fondamental :
qu’est-ce qui permettrait de constater qu’elle est vraie ?
Commençons par ce qui existe réellement
Au 15 septembre 2026, le modèle phare officiellement publié par SpaceXAI reste Grok 4.6, sorti le 12 août.
SpaceXAI le décrit comme un modèle orienté vers les agents de longue durée, le code et le travail intellectuel complexe. L’entreprise affirme notamment qu’il égale GPT-5.6 Sol sur l’Artificial Analysis Intelligence Index.
La page officielle des actualités de l’entreprise ne contient actuellement aucune annonce de sortie pour Grok 4.7, 4.8, 4.9 ou 5.
Il faut donc immédiatement séparer deux catégories :
Grok 4.6 est un produit testable.
Grok 4.7 à 5 constituent aujourd’hui une roadmap annoncée principalement par Elon Musk.
Les confondre transformerait des prédictions en résultats.
La roadmap est devenue extraordinairement agressive
Selon Musk, Grok 4.8 serait un modèle de 2 500 milliards de paramètres, entraîné avec une nouvelle stack logicielle en C++, dont la phase principale d’entraînement doit se terminer cette semaine avant le reinforcement learning.
Puis viendraient Grok 4.9 et Grok 5.
Ce rythme est suffisamment rapide pour produire un effet psychologique trompeur : chaque numéro donne l’impression d’être une marche mesurable vers une destination connue.
4.7.
4.8.
4.9.
AGI.
Mais l’AGI n’est pas une version logicielle.
Et aucun nombre de paramètres n’en constitue la définition.
Un modèle de 2 500 milliards de paramètres peut encore ne rien prouver
La taille d’un modèle est intéressante pour comprendre son architecture et son coût.
Elle ne donne pas directement son niveau d’intelligence.
Un modèle plus grand peut être sous-entraîné. Un modèle plus petit peut disposer de meilleures données, d’un meilleur post-entraînement, de meilleurs outils ou d’une architecture plus efficace.
La propre présentation de Grok 4.6 par SpaceXAI attribue ses progrès à un entraînement supplémentaire plus long, des données synthétiques sélectionnées, des données d’ingénierie de meilleure qualité et une recette d’optimisation améliorée pas simplement à un nombre de paramètres.
Même si Grok 4.8 possède réellement 2 500 milliards de paramètres, cette information dit essentiellement :
« xAI entraîne un très gros modèle ».
Pas :
« xAI approche nécessairement l’AGI ».
Le problème commence avec le mot « AGI »
OpenAI utilise historiquement une définition assez économique :
des systèmes hautement autonomes surpassant les humains dans la plupart des travaux ayant une valeur économique.
Google DeepMind a proposé une approche différente, séparant notamment la profondeur des performances et la largeur ou généralité des capacités, avec plusieurs niveaux possibles plutôt qu’un interrupteur binaire « AGI / pas AGI ».
D’autres chercheurs privilégient encore :
-
la capacité d’apprentissage général ;
-
le transfert vers des tâches nouvelles ;
-
le raisonnement abstrait ;
-
l’autonomie ;
-
l’adaptation à des environnements inconnus ;
-
ou une combinaison de ces propriétés.
Cela crée une situation assez absurde.
Deux laboratoires peuvent construire exactement le même système et raisonnablement conclure :
« Nous avons atteint l’AGI. »
et :
« Nous n’avons pas atteint l’AGI. »
simplement parce qu’ils ne parlent pas de la même chose.
Les benchmarks actuels aggravent le problème
Un benchmark est utile lorsque la capacité qu’il mesure est précisément définie.
Un modèle peut obtenir 90 % à un test de programmation.
Très bien.
Il peut surpasser un médecin moyen sur certaines questions.
Très bien.
Il peut résoudre des problèmes mathématiques autrefois difficiles.
Encore très bien.
Mais additionner suffisamment de benchmarks impressionnants ne produit pas automatiquement une propriété appelée « intelligence générale ».
Les benchmarks actuels souffrent également de plusieurs problèmes connus : contamination potentielle des données d’entraînement, optimisation directe ou indirecte sur les tests, saturation, dépendance au harness utilisé et écart entre réussite d’un exercice court et exécution fiable d’un travail réel pendant plusieurs heures ou jours.
Un système peut être surhumain pendant trois minutes et étonnamment fragile pendant trois heures.
Ce contraste est probablement beaucoup plus important pour l’AGI qu’un dixième de point supplémentaire sur un leaderboard.
Alors construisons un test que Grok 5 pourrait réellement échouer
Une affirmation scientifique intéressante doit pouvoir être réfutée.
Si Grok 5 est annoncé comme AGI, je voudrais au minimum que cinq propriétés soient testées publiquement.
1. Une véritable largeur de compétences
Pas vingt variantes de raisonnement verbal.
Un même système devrait performer à un niveau humain élevé dans des domaines réellement différents : programmation, analyse scientifique, recherche documentaire, planification, communication, manipulation de logiciels, raisonnement quantitatif et tâches professionnelles.
La généralité doit être mesurée horizontalement, pas seulement verticalement.
2. Le transfert vers des problèmes qu’il n’a jamais appris à reconnaître
Le test le plus intéressant n’est pas :
« connaît-il ce problème ? »
mais :
« peut-il comprendre une classe de problème réellement nouvelle avec peu d’exemples ? »
C’est une propriété essentielle de l’intelligence humaine.
Une évaluation sérieuse de l’AGI devrait donc réserver une partie importante de ses environnements jusqu’après l’entraînement et éviter les exercices déjà devenus célèbres sur Internet.
3. Une autonomie de longue durée
Un système général ne devrait pas avoir besoin qu’un humain redécompose chaque travail en quinze prompts.
Donnons-lui un objectif de plusieurs heures ou plusieurs jours.
Il doit rechercher, planifier, utiliser des logiciels, détecter ses propres erreurs, changer de stratégie, conserver son contexte et finalement produire un résultat vérifiable.
Le critère important n’est pas qu’il réussisse une démonstration exceptionnelle.
C’est la fréquence à laquelle il termine correctement.
4. La capacité de savoir qu’il ne sait pas
Une intelligence extrêmement compétente mais incapable d’identifier ses propres incertitudes reste dangereusement fragile.
Il faut donc mesurer non seulement les réponses correctes, mais aussi la calibration :
quand Grok 5 affirme avoir 90 % de chances d’avoir raison, est-il effectivement correct environ neuf fois sur dix ?
Peut-il reconnaître qu’une information lui manque ?
Peut-il demander la bonne donnée au bon moment ?
L’intelligence n’est pas seulement produire une réponse.
C’est également déterminer quand aucune réponse fiable n’est encore possible.
5. Une performance réelle sans choisir uniquement ses terrains favoris
Enfin, l’évaluation devrait être administrée sur des tâches définies par plusieurs organismes indépendants et révélées tardivement.
Sinon, le constructeur du modèle possède un avantage évident : il peut sélectionner les benchmarks sur lesquels son système paraît le plus impressionnant.
Une AGI suffisamment générale ne devrait pas dépendre d’une sélection éditoriale particulièrement avantageuse de tests.
Et même cette grille ne réglerait pas tout
Elle ne créerait toujours pas une définition philosophique universelle de l’intelligence.
Ce n’est pas nécessaire.
Elle ferait quelque chose de plus utile :
transformer « Grok 5 sera une AGI » en affirmation réfutable.
Imagine :
-
généralité : réussie ;
-
transfert : réussi ;
-
autonomie longue : insuffisante ;
-
calibration : insuffisante ;
-
travail réel : proche du niveau humain.
Nous pourrions alors avoir une discussion précise sur ce qui manque.
C’est infiniment plus informatif que de débattre pendant trois semaines pour savoir si le mot AGI « semble approprié ».
AGI et superintelligence ne sont pas synonymes
Une autre confusion va inévitablement arriver.
Si un système atteint une intelligence générale comparable ou supérieure à l’humain dans une grande variété de tâches, cela ne signifie pas nécessairement qu’il possède une superintelligence écrasant les meilleurs humains dans tous les domaines.
Un médecin généraliste humain possède une intelligence générale.
Il n’est pas meilleur que chaque chirurgien, mathématicien, programmeur, physicien et avocat de la planète.
Une future AGI pourrait fonctionner de la même manière : extraordinairement polyvalente sans être omnisciente.
Cette distinction devient essentielle lorsque Musk ajoute que Grok 5 pourrait être « better than anything ».
Meilleur modèle disponible et AGI sont deux affirmations totalement différentes.
Musk avait lui-même beaucoup plus de doute il y a moins d’un an
En octobre 2025, Elon Musk estimait publiquement à environ 10 % la probabilité que Grok 5 atteigne l’AGI.
En septembre 2026, sa formulation est devenue beaucoup plus catégorique : lorsqu’on lui demande si Grok 4.8 s’en approchera, il renvoie directement à Grok 5.
Peut-être xAI a-t-elle obtenu des résultats internes extraordinaires.
C’est possible.
Mais le public ne les possède pas.
Et tant qu’ils ne sont pas disponibles, la position rationnelle n’est ni :
« Musk ment ».
ni :
« Grok 5 sera l’AGI ».
C’est :
nous avons une prédiction faite par le dirigeant de l’entreprise qui construit le modèle.
Elle deviendra intéressante lorsqu’elle sera confrontée aux données.
La première AGI ne devrait pas dépendre de celui qui prononce le mot en premier
La course actuelle crée une incitation évidente.
Être la première entreprise capable de dire :
« Nous avons créé l’AGI »
serait probablement l’une des annonces technologiques les plus puissantes de l’histoire moderne.
Ce prestige rend justement indispensable l’existence de critères définis avant le résultat.
Sinon, le terme peut être déplacé jusqu’à ce qu’il corresponde au produit que l’on vient de construire.
C’est l’équivalent d’organiser une course sans ligne d’arrivée puis de laisser chaque concurrent tracer la sienne sous ses propres pieds.
Grok 5 pourrait devenir exceptionnel.
Il pourrait même devenir le système qui nous forcera collectivement à reconnaître que quelque chose a changé.
Mais si cela arrive réellement, nous ne devrions pas avoir besoin d’un tweet d’Elon Musk pour nous en convaincre.
Une véritable AGI devrait être identifiable dans ses capacités avant de l’être dans son marketing.