J’ai fait passer un benchmark de raisonnement à cinq IA : ChatGPT a obtenu 99/100, et les erreurs sont plus intéressantes que le classement
J’ai demandé à GPT-6 Astra de concevoir un benchmark inédit mêlant logique, probabilités, causalité, concurrence logicielle, optimisation et auto-vérification. ChatGPT, Gemini, DeepSeek, Kimi et Grok l’ont ensuite passé sans accès au corrigé. Le résultat n’est pas seulement un classement : c’est une radiographie assez brutale de la façon dont ces modèles raisonnent, prouvent… et parfois persistent dans leurs propres erreurs.
Il y a un problème avec beaucoup de comparatifs d’IA : on pose dix questions, on regarde laquelle semble la plus intelligente, puis on transforme ça en classement définitif.
Je voulais quelque chose de beaucoup plus méchant.
Pas un quiz de culture générale. Pas vingt exercices de maths récupérés sur Internet. Pas un concours où une réponse finale correcte suffit à masquer un raisonnement bancal.
J’ai donc demandé à GPT-6 Astra de concevoir une véritable épreuve de raisonnement, avec une clé de correction privée préparée avant de recevoir les réponses. Puis j’ai envoyé exactement le même benchmark à cinq systèmes : ChatGPT, Gemini, DeepSeek, Kimi et Grok.
Le résultat brut est spectaculaire :
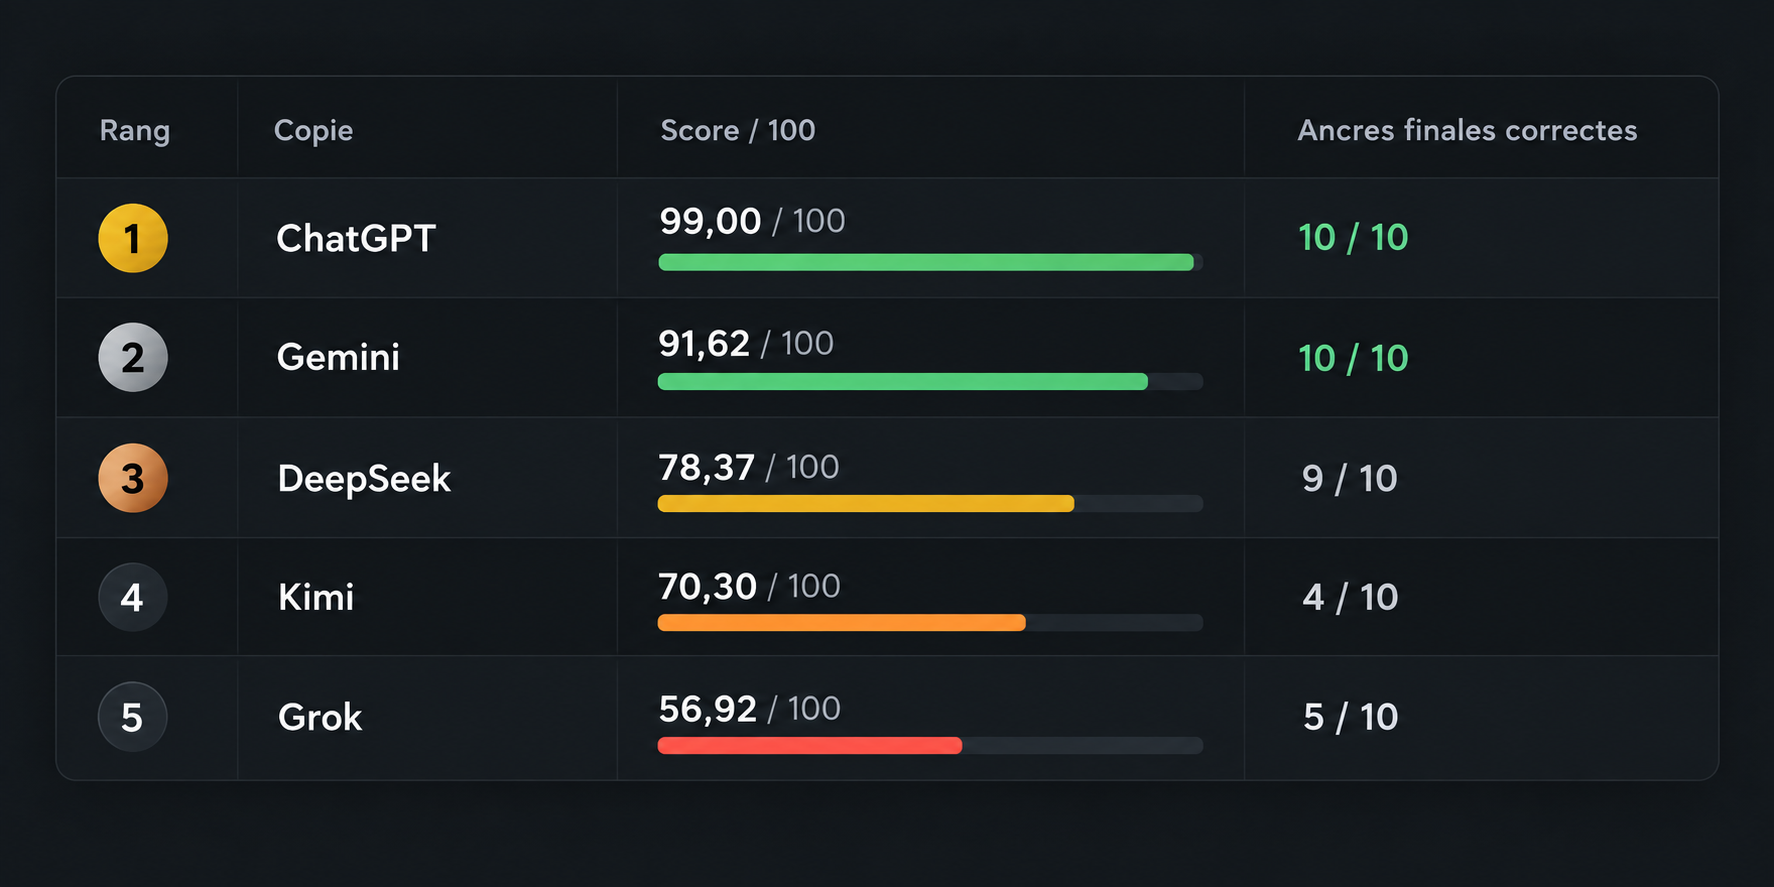
Mais ce tableau est presque la partie la moins intéressante de l’expérience.
Parce que GAUNTLET ne mesurait pas seulement si un modèle trouvait la bonne réponse. Il essayait de voir s’il pouvait démontrer qu’elle était bonne, résister à de fausses pistes, manipuler un système entièrement nouveau, rester cohérent pendant des milliers de mots et détecter ses propres erreurs avant de rendre sa copie. Le corrigé attribuait ainsi 41 points aux conclusions, mais 49 points aux justifications, auxquels s’ajoutaient le respect du protocole, la calibration de confiance et l’auto-audit.
C’est précisément là que les différences deviennent intéressantes.
GAUNTLET : dix problèmes, presque aucun refuge dans la mémorisation
Le benchmark comportait dix sections liées entre elles.
S1 commençait par un problème de logique avec six bits et cinq témoignages contradictoires. S2 introduisait un problème bayésien dans lequel deux tests apparemment répétitifs partageaient en réalité une cause cachée. S3 passait à l’inférence causale avec résultats potentiels, confusion et randomisation.
Puis le test changeait complètement de terrain.
S4 demandait d’auditer un service de réservation volontairement défectueux : concurrence, isolation entre utilisateurs, expirations, idempotence, crashs, linéarisabilité et conservation d’un stock. À elle seule, cette partie valait quinze points.
S5 était un problème d’optimisation robuste avec adversaire, loteries et valeur de l’information. S6 définissait ensuite un système mathématique inventé pour le benchmark, où les modèles devaient comprendre six bits évoluant lors de la lecture de lettres A, B et C, dériver la loi de concaténation, calculer une répétition de longueur gigantesque puis prouver la longueur minimale d’un mot particulier.
S7 reprenait ce système pour demander quelles informations pouvaient être compressées sans perdre le pouvoir de distinguer deux mots. S8 mélangeait ordonnancement de tâches, ressources partagées et une autorisation dont la validité dépendait d’une frontière temporelle stricte. S9 dispersait plusieurs politiques à travers le document avec versions, signatures et une fausse instruction de type « SYSTEM OVERRIDE ». Enfin, S10 obligeait le modèle à reprendre plusieurs résultats précédents et à classer précisément des propositions comme PROUVÉES, RÉFUTÉES ou INDÉTERMINÉES.
Ce mélange est volontaire.
Une IA excellente en calcul mais médiocre en lecture de spécification pouvait tomber. Une IA excellente en programmation mais trop rapide dans ses preuves pouvait tomber. Une IA capable de trouver intuitivement les bonnes réponses mais incapable d’établir une borne d’optimalité perdait également des points.
Et surtout : une réponse juste n’était pas automatiquement une bonne réponse.
Le détail que j’aime le plus : le corrigé existait avant les candidats
GAUNTLET possédait un document public et une clé privée séparée.
Le corrigé fixait les solutions, mais également le barème détaillé, les alternatives acceptables, les conditions de demi-crédit et les règles destinées à empêcher de modifier les critères une fois les copies reçues. Des empreintes SHA-256 étaient également enregistrées pour figer les documents. La clé prévoyait même des scripts privés permettant de vérifier certaines parties finies du benchmark : 64 états logiques, optimisation des plans, associativité du système de S6, plusieurs milliers d’historiques logiciels, etc.
C’est une différence fondamentale avec un « je demande à ChatGPT de noter ChatGPT ».
La correction restait partiellement humaine pour les démonstrations ouvertes, mais les réponses attendues et les critères existaient avant de savoir qui allait réussir ou échouer.
Ce genre de précaution rejoint d’ailleurs les préoccupations des évaluations sérieuses : Stanford présente HELM comme un cadre transparent et reproductible et publie les requêtes et résultats au niveau des prompts ; OpenAI insiste de son côté sur le fait que les performances modernes dépendent non seulement du modèle mais aussi du harnais d’évaluation, de l’environnement et de la configuration qui lui permet d’agir.
GAUNTLET n’est évidemment pas HELM. C’est une expérience artisanale avec cinq copies. Mais au moins, elle essaie de poser la bonne question : qu’est-ce qui a réellement été mesuré ?
ChatGPT : presque la copie parfaite
Le score de ChatGPT mérite d’être regardé de près : 41/41 sur les conclusions et 48/49 sur les justifications.
Autrement dit, aucune conclusion notée n’était fausse.
Il réussit les dix ancres, la partie logicielle obtient 15/15, le nouveau système mathématique 9/9, l’abstraction de S7 7/7 et le planning de S8 8/8.
Les deux seuls demi-points perdus sont presque frustrants tant ils sont petits.
Dans le problème décisionnel de S2, GPT calcule correctement toutes les probabilités, choisit correctement l’examen C et trouve le risque optimal exact de 121/95, mais ne dérive pas explicitement le seuil général de décision :
12p \le 3(1-p)
d’où
p \le \frac15.
En S5, il trouve également la bonne stratégie adaptative donnant une garantie de 17 avec un diagnostic coûtant une unité, mais ne fournit pas la borne qui prouve que 17 est réellement optimal parmi tous les plans possibles avec le budget restant.
Ce sont les deux seuls trous.
C’est justement ce qui rend le 99 intéressant : ce n’est pas un 99 obtenu parce que le juge était indulgent sur des réponses « à peu près bonnes ». Le modèle trouve pratiquement tout, et ce qui lui manque est identifiable à deux petites obligations de preuve.
Gemini trouve également les dix réponses principales… mais pas avec la même solidité
Voilà pourquoi regarder uniquement « 10/10 ancres » aurait été trompeur.
Gemini obtient lui aussi les dix ancres finales correctes. Pourtant son score descend à 91,62.
La différence est presque entièrement dans les démonstrations.
L’exemple le plus parlant apparaît dans la partie logicielle. Lors d’une course concurrente sur un stock initial de 1, deux réservations lisent toutes deux n=1, puis écrivent chacune 0. Gemini présente le bug comme un stock devenant négatif.
Mais ce n’est pas ce qui se produit.
Le stock reste 0.
Le vrai problème est plus subtil et plus grave : deux réservations d’une unité existent alors que le stock initial n’en contenait qu’une. L’invariant de conservation est brisé sans que le compteur libre devienne négatif.
C’est exactement le genre d’erreur que j’attendais du test : le modèle reconnaît correctement qu’il existe une race condition, mais invente le mauvais mécanisme.
Sa proposition de correction logicielle présente également une sérialisation insuffisante autour de l’identité (tenant,key), ainsi qu’une justification trop faible face aux crashs. Résultat : seulement 10,625/15 en S4, contre 15 pour ChatGPT.
Gemini dépasse aussi la limite imposée de 6 500 mots, avec environ 7 153 unités selon la règle de comptage du benchmark. Cela ne lui coûte que 0,25 point, mais illustre autre chose : suivre une longue spécification fait partie de la tâche.
Donc oui, Gemini connaissait toutes les destinations.
ChatGPT construisait simplement de meilleures routes pour y arriver.
DeepSeek : neuf bonnes ancres, puis une compression de trop
DeepSeek est probablement la copie qui montre le mieux pourquoi une seule erreur conceptuelle peut être fascinante.
Il obtient 9 ancres sur 10.
Puis arrive S7.
Le problème demande si les six bits construits dans la section précédente sont tous nécessaires pour déterminer ce qu’un observateur peut distinguer après avoir ajouté n’importe quel préfixe et n’importe quel suffixe.
DeepSeek décide que non.
Il affirme que les bits b, c et q n’influencent jamais le résultat observable et conclut qu’il suffit de conserver trois bits : (a,p,r).
C’est faux.
Et un contre-exemple minuscule détruit toute l’idée.
Prenons le mot vide et BC. Tous deux possèdent les mêmes valeurs pour les trois bits proposés par DeepSeek :
(a,p,r)=(0,0,0).
Ajoutons maintenant le préfixe A.
Le mot vide devient A, dont r=0.
BC devient ABC, dont r=1.
Les deux objets que la compression de DeepSeek déclarait identiques deviennent donc observablement différents. L’information supprimée était nécessaire.
C’est une très belle erreur parce qu’elle n’est pas un calcul raté. C’est une mauvaise abstraction.
DeepSeek avait parfaitement compris la mécanique locale du système en S6. Il perd pourtant une propriété globale lorsque des contextes arbitraires sont autorisés.
Son score final, 78,37, vient aussi d’un autre comportement récurrent : beaucoup de bonnes valeurs finales, mais trop peu de certificats exhaustifs. Dire qu’une borne est optimale ne suffit pas lorsqu’on vous demande précisément pourquoi aucune autre solution ne peut la dépasser.
Kimi est le cas le plus étrange de tout le benchmark
Kimi termine quatrième avec 70,30/100 et seulement quatre ancres justes.
Pris comme ça, le résultat paraît simplement mauvais.
Puis on regarde S4.
14/15.
Sur le problème de génie logiciel le plus lourd de tout le benchmark, Kimi fait mieux que Gemini et DeepSeek et n’est qu’à un point de ChatGPT. Sa conception transactionnelle est cohérente, il comprend correctement les expirations, les clés composites, les rejeux, la persistance et l’atomicité.
Et quelques sections plus loin, il peut complètement dérailler.
Dans S1, ses deux configurations finales sont carrément incompatibles avec les contraintes physiques : 010111 possède quatre bits à 1 alors qu’il doit y en avoir exactement trois ; 011100 active simultanément c et d, explicitement interdit.
Plus intéressant encore : son auto-audit contient une erreur presque comique.
En revérifiant le sceau de S6, Kimi calcule lui-même des composantes qui donnent :
110011
… puis écrit immédiatement que son ancienne réponse :
111001
est confirmée.
Il venait de produire la correction dans son propre texte et ne l’a pas reconnue comme telle. Le registre final conserve donc la mauvaise valeur avec une confiance de 94 %.
C’est probablement mon observation préférée de l’expérience.
On parle souvent « d’auto-réflexion » des modèles comme s’il suffisait de leur demander « vérifie ta réponse ». Ici, Kimi effectue réellement un calcul de vérification qui contredit sa réponse précédente… puis ignore la contradiction.
Le benchmark comptait précisément ce phénomène. Kimi termine avec cinq ancres fausses annoncées à au moins 90 % de confiance et le pire Brier moyen du groupe : 0,54501. ChatGPT est à 0,00040 et Gemini à 0,00001 sur ces dix événements.
L’erreur n’est donc pas seulement « avoir tort ».
C’est avoir tort, disposer de l’information permettant de s’en rendre compte, puis rester extrêmement sûr d’avoir raison.
Grok : parfois excellent, parfois totalement hors des rails
Grok termine à 56,92/100, dernier de cette campagne.
Ce serait pourtant une erreur de traduire ça en « Grok est mauvais partout ».
Sa partie causale S3 obtient 9,25/10. S1 atteint 7,25/8 et les résultats principaux de S2 sont également solides.
Puis certaines sections s’effondrent.
En S6, il propose une longueur minimale de 5 pour obtenir un sceau dont les trois compteurs de lettres valent zéro. Mais si chacun des nombres de A, B et C doit être pair et strictement positif pour produire le bit final recherché, la longueur totale ne peut même pas être impaire. Son témoin BABAC donne par ailleurs 001101, pas 000001.
Il affirme ensuite avoir couvert les mots de longueur inférieure ou égale à 4 avec « 3^4=81 mots ». Mais 81 est seulement le nombre de mots de longueur exactement 4. En comptant les longueurs 0, 1, 2, 3 et 4, il y en a :
1+3+9+27+81=121.
La section de planning est encore plus brutale : 0,5/8.
Grok propose notamment Q de 4 à 6. Or cette tâche crée une autorisation valide de 6 à 8. Il veut ensuite valider F à 9.
L’autorisation est donc expirée depuis une unité de temps.
Le plus curieux est que son propre S10 reconnaît correctement ce fait lorsqu’on lui pose explicitement la question. La copie contient ainsi la bonne réfutation locale sans parvenir à la faire remonter dans son planning principal.
Ce n’est pas un problème de connaissance.
C’est un problème de cohérence globale.
Le score de confiance raconte une autre histoire
GAUNTLET obligeait chaque modèle à annoncer une probabilité de confiance pour chaque réponse principale.
Ce détail aurait pu être décoratif. Il ne l’était pas.
Le score utilisait une variante du Brier score, qui pénalise une probabilité selon l’écart entre la confiance annoncée et le résultat réel. Une erreur annoncée à 50 % n’a donc pas le même sens qu’une erreur annoncée à 99 %.
Et là, les profils divergent fortement.
Gemini est presque absurdement confiant essentiellement 99 ou 100 % mais ses dix ancres sont effectivement correctes. Sur cet échantillon minuscule, cela lui donne la meilleure calibration numérique.
Kimi est également très confiant.
Sauf que six ancres sont fausses.
La différence entre « assurance » et « calibration » apparaît immédiatement.
C’est une caractéristique que j’aimerais voir beaucoup plus souvent dans les benchmarks. Une IA qui dit « je suis à 55 % » avant une réponse difficile et se trompe ne présente pas le même risque qu’une IA qui produit la même erreur en déclarant 99 %.
Dans un système autonome, cette distinction peut devenir plus importante que quelques points d’exactitude brute.
Et l’auto-audit n’a réparé aucune ancre fausse
Chaque modèle devait identifier ses trois sections de plus faible confiance, revenir dessus avec une vérification concrète, puis modifier sa réponse si nécessaire.
C’était une occasion explicite de se sauver.
Résultat : aucun des cinq modèles n’a transformé une ancre initialement fausse en ancre finale correcte.
ChatGPT, Gemini et DeepSeek obtiennent tout de même les quatre points d’audit parce qu’ils sélectionnent correctement leurs sections fragiles et effectuent de vrais contrôles sur des ancres déjà justes.
Kimi réalise quelques contrôles valables, mais maintient ses erreurs.
Grok ne gagne aucun point d’auto-audit.
Je trouve ce résultat plus important qu’il n’en a l’air.
Faire produire davantage de texte à un modèle n’est pas automatiquement équivalent à le rendre plus fiable. Un second passage peut confirmer une erreur avec davantage d’éloquence. Il peut également recalculer correctement quelque chose sans mettre à jour la conclusion qui en dépend.
La vérification doit avoir une structure.
Alors, ChatGPT est-il « 1,74 fois plus intelligent » que Grok ? Non.
C’est là qu’un benchmark devient dangereux si on commence à aimer un peu trop son propre tableau.
Ce test ne permet pas de conclure que ChatGPT possède « 99 % d’intelligence », que Gemini vaut 91,62 % d’un humain expert ou que ChatGPT est intrinsèquement meilleur que tous les produits de Google, DeepSeek, Moonshot ou xAI.
Même le rapport de correction refuse explicitement cette interprétation.
Les versions exactes des cinq systèmes, leurs paramètres, budgets de raisonnement et éventuelles différences de harnais n’ont pas été vérifiés de manière suffisamment rigoureuse. Les noms des candidats étaient connus pendant la correction, donc celle-ci n’était pas aveugle. Il n’y a eu qu’un essai par système. Plusieurs sections sont corrélées, notamment S6/S7 et S10 avec les problèmes précédents. Et cinq copies restent un échantillon microscopique.
La recherche moderne sur les benchmarks insiste justement sur ce genre de limites. HELM sélectionne notamment les tâches selon leur saturation, leur récence, leur qualité et leur reproductibilité. La littérature sur la contamination rappelle en parallèle qu’un benchmark public finit par devenir moins fiable dès que ses questions ou leurs variantes peuvent intégrer les données d’entraînement des futurs modèles.
Et GAUNTLET vient maintenant de rencontrer ce problème.
À partir du moment où je publie cet article et les détails du test, GAUNTLET 1.0 commence à mourir comme épreuve secrète.
Une future IA pourrait avoir vu le problème.
Ou son corrigé.
Ou cet article.
Ou une copie dérivée.
Ce n’est plus le même test.
Des travaux récents décrivent précisément la contamination des benchmarks comme une menace croissante : lorsqu’un élément d’évaluation ou une variante proche apparaît dans les données d’entraînement, les performances peuvent être artificiellement gonflées.
La prochaine version devra donc contenir de nouveaux problèmes et une nouvelle clé gelée avant les essais.
Ce que GAUNTLET a réellement mesuré
La meilleure façon de lire ce classement n’est donc pas :
ChatGPT > Gemini > DeepSeek > Kimi > Grok, fin de l’histoire.
La conclusion beaucoup plus intéressante est que cinq systèmes suffisamment avancés pour résoudre une grande partie des mêmes problèmes présentent encore des signatures d’échec radicalement différentes.
ChatGPT a été extrêmement homogène et presque parfaitement démonstratif.
Gemini a trouvé toutes les grandes réponses mais a laissé davantage de fissures dans les preuves, particulièrement lorsqu’il fallait raisonner précisément sur un système concurrent.
DeepSeek a obtenu presque toutes les conclusions principales avant de supprimer une information indispensable dans une abstraction.
Kimi a montré une compétence impressionnante en architecture logicielle au milieu d’erreurs logiques beaucoup plus fondamentales avec, parfois, une confiance extraordinairement mal placée.
Grok a été très fort sur l’inférence causale tout en s’effondrant sur des contraintes temporelles et certaines preuves combinatoires.
Cela rappelle une évidence qu’on oublie derrière les leaderboards : un modèle n’a pas un unique niveau d’intelligence que l’on pourrait résumer proprement par un nombre.
Même les cadres d’évaluation plus établis comme HELM séparent les capacités en scénarios et dimensions plutôt que de prétendre qu’un score unique raconte toute l’histoire.
GAUNTLET n’échappe pas à cette règle.
Son classement est amusant.
Ses erreurs sont beaucoup plus instructives.
Et après avoir lu les cinq copies, la chose qui m’intéresse le plus pour une version 2 n’est même plus de rendre les questions simplement « plus difficiles ».
Je veux fabriquer des situations où une première intuition plausible conduit exactement au mauvais résultat, où une solution locale correcte doit survivre à plusieurs sections, où le modèle dispose volontairement d’une seconde chance de découvrir sa contradiction et où être sûr de soi au mauvais moment coûte cher.
Parce qu’une IA qui ne connaît pas une réponse est un problème relativement simple.
Une IA qui trouve une réponse fausse, construit autour d’elle une démonstration élégante, la vérifie, rencontre la preuve qu’elle s’est trompée… puis annonce 94 % de confiance ?
Ça, c’est beaucoup plus intéressant.
P.S. - Claude et Mistral devaient eux aussi participer au benchmark. Dans les deux cas, l’épreuve s’est terminée par une erreur serveur avant que je puisse récupérer une réponse complète. Gemini m’a fait le même coup deux fois ; ce n’est qu’à la troisième tentative qu’il a finalement rendu sa copie. Je préfère donc parler ici uniquement des modèles pour lesquels j’ai réellement obtenu une réponse complète, plutôt que d’inventer un score à ceux qui n’ont jamais franchi la ligne d’arrivée.