La guerra secreta para copiar las mejores IA
Cientos de millones de solicitudes, miles de cuentas falsas y modelos entrenados con las respuestas de sus competidores: la destilación se ha convertido en un asunto industrial y geopolítico. Pero entre el aprendizaje legítimo, la extracción de capacidades y el verdadero robo, la frontera es mucho menos simple de lo que parece.
151 millones de intercambios.
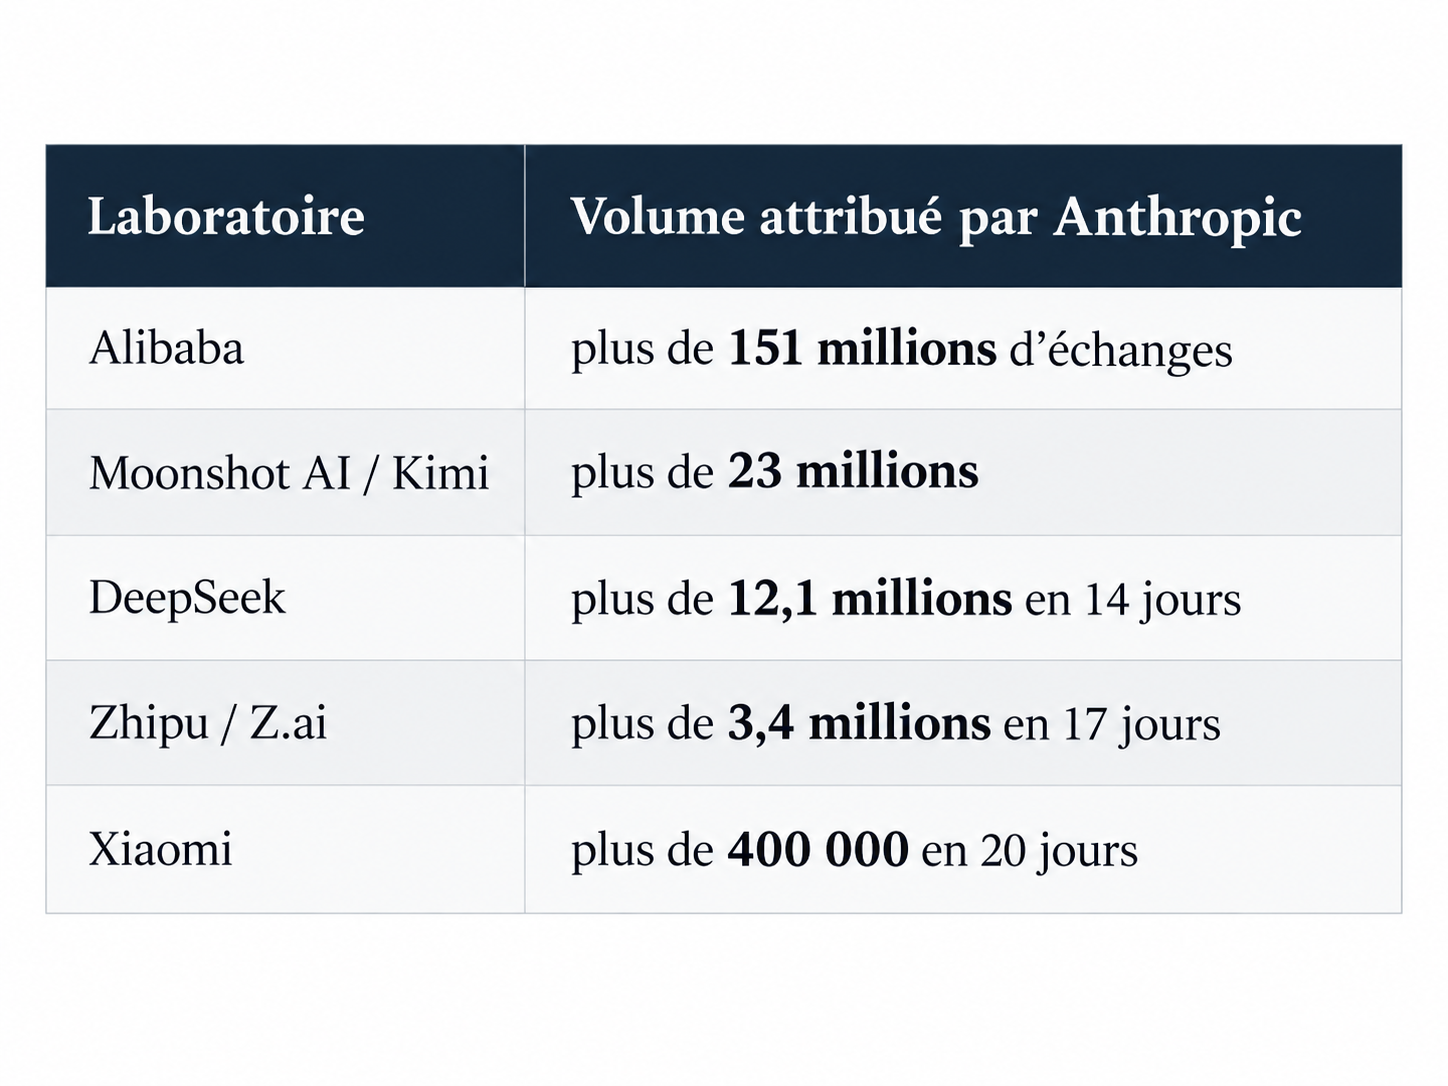
Es el volumen que Anthropic afirma haber observado, entre mayo y julio de 2026, en una campaña atribuida a Alibaba dirigida contra Claude.
No 151 millones de tokens. No 151 millones de caracteres. Más de 151 millones de intercambios con el modelo.
En el momento álgido de la operación, Anthropic dice haber medido cerca de tres millones de intercambios por día. Una primera infraestructura habría utilizado cerca de 5.000 cuentas fraudulentas, con proxies residenciales, direcciones de correo desechables y tarjetas de pago virtuales. Cuando estas cuentas fueron bloqueadas, el tráfico habría migrado a otra infraestructura.
El objetivo presunto no era hacer preguntas a Claude porque Alibaba necesitara un chatbot.
Según Anthropic, las respuestas y, notablemente, rastros de razonamiento eran transformados en datos de entrenamiento destinados a mejorar los modelos Qwen.
En otras palabras: hacer trabajar a una IA extremadamente avanzada como profesor clandestino de otra IA.
Parece inmediatamente un robo.
El problema es que la técnica utilizada lleva un nombre perfectamente respetable en la investigación en inteligencia artificial.
La destilación.
Y no tiene absolutamente nada de ilegal ni de maliciosa por naturaleza.
Una IA puede realmente aprender de otra IA
El principio de la destilación es sorprendentemente simple.
Tomemos un modelo muy potente, al que llamaremos el profesor.
Se le someten enormes cantidades de problemas:
-
escribir o corregir código;
-
resolver razonamientos complejos;
-
clasificar documentos;
-
usar herramientas;
-
analizar datos;
-
responder preguntas especializadas.
Se conservan sus respuestas.
Luego se usa este inmenso conjunto de ejemplos para entrenar otro modelo, el alumno.
El alumno no recibe los pesos internos del profesor. No obtiene su código fuente. No recupera una copia exacta de su cerebro digital.
Simplemente observa, una y otra vez, cómo un modelo mucho más competente se comporta ante diferentes problemas.
Eso ya es extremadamente valioso.
La técnica ni siquiera es nueva. En 2015, Geoffrey Hinton, Oriol Vinyals y Jeff Dean publicaban Distilling the Knowledge in a Neural Network, mostrando cómo transferir parte de los conocimientos de un sistema complejo hacia un modelo más simple y menos costoso de usar.
Hoy, toda la industria usa este principio.
OpenAI propone oficialmente un sistema de Model Distillation que permite usar las salidas de modelos potentes para afinar modelos más pequeños y baratos. Google también propone usos legítimos de la destilación.
La destilación no es, por tanto, el problema.
La pregunta es: ¿quién es el profesor, quién es el alumno, y ha aceptado el profesor dar la clase?
Destilación, extracción, copia: las palabras ocultan cosas distintas
Una confusión vuelve constantemente en este asunto: usar las respuestas de una IA para entrenar otra IA no equivale necesariamente a “robar el modelo”.
Hay que distinguir varios niveles.
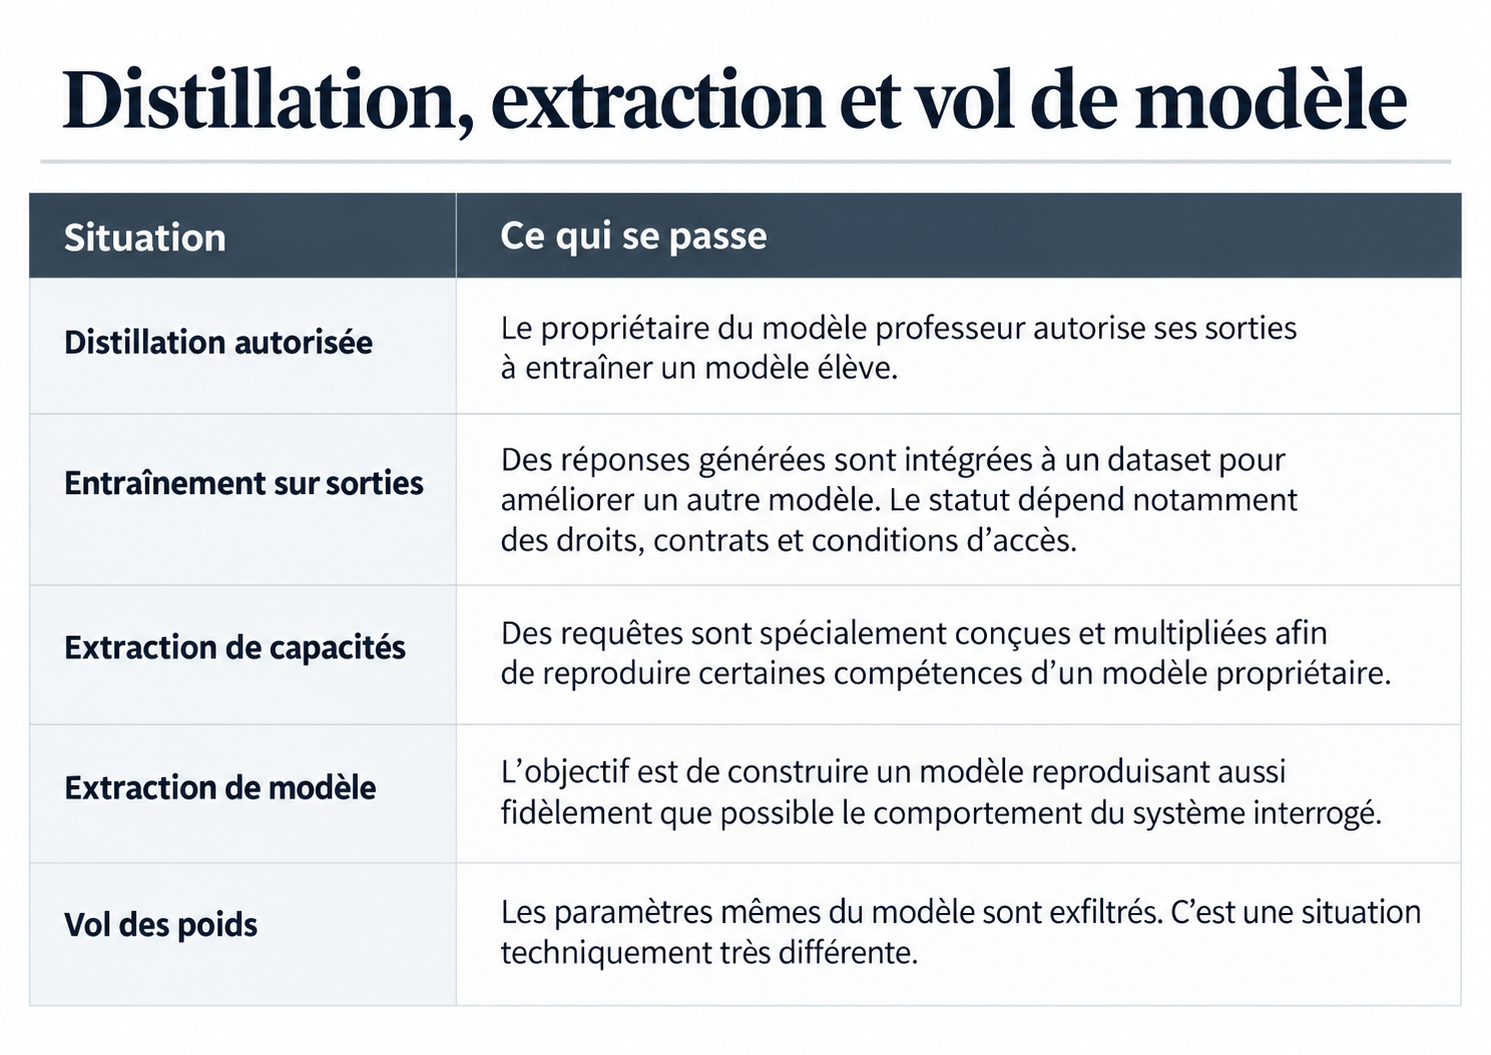
El término model extraction no fue inventado para la guerra actual entre los laboratorios de IA.
Ya en 2016, investigadores habían mostrado que un modelo accesible solo a través de una API podía a veces ser reconstruido aproximadamente interrogándolo de manera suficientemente inteligente. Su artículo se titulaba sin rodeos Stealing Machine Learning Models via Prediction APIs.
El principio crea un paradoxo fundamental.
Para vender una IA, hay que dejar que los usuarios la interroguen.
Pero cada respuesta revela también algo de su comportamiento.
Una solicitud aislada casi no vale nada.
Millones de solicitudes elegidas metódicamente pueden convertirse en un dataset extremadamente valioso.
Lo que Anthropic acusa realmente a los laboratorios chinos de haber hecho
Hay que ser preciso aquí.
La información detallada disponible públicamente proviene principalmente de las investigaciones y atribuciones de Anthropic. No constituyen, por sí solas, una decisión judicial independiente que establezca cada hecho.
Pero los volúmenes alegados son lo bastante enormes para cambiar completamente la naturaleza del asunto.
En su informe de septiembre de 2026, Anthropic afirma en particular haber identificado:
Ya no estamos realmente en el escenario de un investigador enviando algunos miles de prompts para estudiar a un competidor.
Anthropic describe verdaderos pipelines industriales.
En el caso atribuido a Zhipu, por ejemplo, el laboratorio habría registrado los razonamientos recuperados y luego usado Claude mismo para limpiarlos, normalizarlos, evaluarlos y generar otros datos destinados al entrenamiento.
El profesor ya no serviría solo para producir las respuestas.
Participaría también en la fabricación de su propio dataset de copia.
El caso Alibaba va aún más lejos
La campaña que Anthropic atribuye a Alibaba habría apuntado en particular a las capacidades de razonamiento, programación, desarrollo de núcleos informáticos y tareas largas que requieren varios pasos.
Según Anthropic, prompts imponían a Claude producir rastros de razonamiento explícitos que eran luego guardados y transformados en datos de supervised fine-tuning, o SFT.
El SFT consiste en entrenar un modelo sobre parejas del tipo:
Problème → excellente réponse attendue
Repita esto millones de veces sobre problemas cuidadosamente elegidos y no transmite solo conocimientos fácticos.
Transmite también comportamientos útiles: cómo descomponer un problema, qué estrategia probar, cómo producir código limpio, cómo usar una herramienta o cómo perseguir una tarea durante muchos pasos.
Anthropic afirma que estos datos han servido para mejorar varias generaciones de Qwen. La sociedad acusa también a Alibaba de haber usado Claude para trabajar en sus infraestructuras internas de investigación en IA, notamment entornos de reinforcement learning y ciertos trabajos ligados a las arquitecturas de modelos.
Una vez más: eso no significa que Alibaba habría descargado “el cerebro de Claude”.
Pero si las acusaciones son exactas, Claude habría servido de investigador, profesor, generador de datos y herramienta de evaluación a un competidor.
El matiz técnico no hace el fenómeno menos impresionante.
Lo hace más interesante.
Kimi y DeepSeek: cuando el modelo que usas ya no sería ni siquiera el que te responde
Las acusaciones concernientes a Moonshot AI, creador de Kimi, son probablemente las más inquietantes.
Anthropic afirma haber descubierto que ciertas solicitudes enviadas por usuarios que pensaban interrogar a Kimi eran silenciosamente transmitidas a Claude.
La respuesta producida por Claude habría sido luego devuelta al usuario como respuesta del servicio.
En un período de diez días, Anthropic dice haber recibido cerca de 300.000 solicitudes de clientes de Moonshot en este marco. La infraestructura habría usado 5.380 cuentas fraudulentas. Una parte de los intercambios habría sido luego conservada para alimentar pipelines de entrenamiento. En total, Anthropic atribuye más de 23 millones de intercambios a Moonshot entre mayo y julio.
DeepSeek habría usado un método comparable.
Anthropic afirma que ciertas solicitudes de usuarios de DeepSeek, notamment cuando provenían de herramientas de desarrollo compatibles con diferentes modelos, eran seleccionadas y luego redirigidas hacia Claude Opus.
La respuesta podía así servir inmediatamente, pero también proporcionar un nuevo dato que permita entrenar los futuros modelos propios. Anthropic estima en más de 12,1 millones el número de intercambios asociados a esta campaña en solo catorce días de julio de 2026.
Si estas acusaciones son exactas, ya no hablamos solo de propiedad intelectual.
Hablamos también de confianza del usuario.
El problema oculto: vuestras conversaciones pueden convertirse en materia prima
Es quizás la parte más preocupante del informe.
Anthropic afirma que DeepSeek, Moonshot y Xiaomi han transmitido a Claude ciertas conversaciones inicialmente dirigidas a sus propios modelos.
Y una conversación con una IA de programación puede contener mucho más que una pregunta abstracta.
Puede contener:
-
código propietario;
-
documentos internos;
-
claves de API;
-
identificadores;
-
datos profesionales;
-
nombres y contactos;
-
archivos de configuración;
-
informaciones confidenciales.
Anthropic dice haber observado en las sesiones concernidas informaciones sensibles pertenecientes a cientos de usuarios y organizaciones, en al menos una docena de lenguas.
En el caso Xiaomi, Anthropic afirma que más de 400.000 solicitudes provenientes de más de 1.500 cuentas han sido enviadas a Claude. Las conversaciones habrían servido luego para construir datos de SFT y de reinforcement learning para futuros modelos.
Hay, por tanto, potencialmente dos recursos extraídos al mismo tiempo:
la capacidad del modelo competidor, y los datos de los usuarios.
No son en absoluto los mismos problemas jurídicos o éticos.
Pero pueden pasar por exactamente el mismo tubo.
Se pueden incluso comprar conversaciones con una IA
El informe de Anthropic describe una etapa suplementaria: la aparición de un mercado secundario de datos de destilación.
Servicios intermediarios dan acceso a modelos normalmente indisponibles en ciertas regiones. Transmiten las solicitudes hacia Claude u otros modelos, recuperan las respuestas… y pueden conservar las conversaciones.
Anthropic afirma que ciertos de estos datos habrían sido luego revendidos a otros laboratorios.
SenseTime habría así usado conversaciones Claude compradas a proveedores terceros.
Anthropic acusa par ailleurs a MiniMax de haber creado su propia red de proxy a través de una sociedad pantalla que proponía, curiosamente, solo el acceso a modelos de Anthropic y de OpenAI y no a los modelos de MiniMax mismo. Anthropic estima que esta infraestructura servía para cosechar intercambios para el entrenamiento.
Si este modelo económico se confirma a gran escala, cambia profundamente la situación.
Una conversación con una IA ya no es solo una interacción entre un usuario y un proveedor.
Puede convertirse en un activo revendible para entrenar una tercera IA.
El gobierno estadounidense ha entrado ahora en la batalla
El 8 de septiembre de 2026, la NSA, el FBI y la CISA publicaron juntos una alerta consagrada a este fenómeno.
El documento acusa a empresas chinas de organizar campañas de destilación contra los modelos estadounidenses a escala industrial.
El argumento estadounidense es económico tanto como securitario: reproducir ciertas capacidades de modelos existentes permitiría reducir una parte del coste necesario para desarrollarlos independientemente: cálculo, energía, investigación fundamental y experimentación.
La destilación es, por tanto, presentada ahora no solo como un problema comercial, sino como un asunto estratégico en la competencia tecnológica entre Estados Unidos y China.
Y China rechaza este relato.
El ministerio chino de Asuntos Exteriores ha respondido que los progresos del país en inteligencia artificial provenían de sus capacidades científicas y tecnológicas y de su política de apertura y cooperación. Pekín ha pedido a Estados Unidos que cesen lo que considera acusaciones infundadas y intentos de denigración.
Tenemos, por tanto, dos lecturas casi opuestas del mismo fenómeno.
Para Washington y varios laboratorios estadounidenses: extracción industrial de propiedad intelectual.
Para Pekín: una acusación política dirigida a empresas chinas en un sector donde la competencia se ha vuelto estratégica.
La técnica existe.
Su interpretación es ahora geopolítica.
La palabra “robo” merece sin embargo ser usada con precisión
Google no toma muchas precauciones léxicas: su equipo de Threat Intelligence describe los ataques de extracción de modelos como una forma de espionaje industrial y de robo de propiedad intelectual.
Google afirma también observar regularmente campañas de gran amplitud e indicaba recientemente que ciertas superaban 100 millones de prompts.
OpenAI mantiene una posición comparable.
La empresa reconoce explícitamente que existen usos legítimos de la destilación, ella misma proporciona las herramientas, pero afirma también haber observado actividades asociadas a DeepSeek que considera compatibles con una destilación adversarial y tentativas de evasión de sus restricciones.
Anthropic prohíbe por su parte en sus condiciones comerciales usar sus servicios para construir un producto competidor o entrenar un modelo de IA competidor sin autorización explícita.
Pero varias preguntas deben permanecer separadas.
Violaciones contractuales, extracción técnica, propiedad intelectual, confidencialidad y calificación penal no son sinónimos.
Decir que un laboratorio ha usado fraudulentamente miles de cuentas para evadir restricciones es una afirmación.
Decir que ha reproducido ciertas capacidades de un competidor usando sus salidas es otra.
Decir que ha “robado el modelo” puede finalmente dar la impresión de que sus pesos han sido sustraídos, lo que no es lo que describen estos informes.
El lenguaje de las empresas no es neutro.
Cuando Anthropic dice illicit distillation, o cuando Google habla de IP theft, estas empresas describen un problema técnico real, pero defienden también un activo comercial que vale enormemente.
Eso no vuelve sus acusaciones falsas.
Obliga simplemente a no confundir su vocabulario con una definición universal.
¿Se puede realmente copiar a Claude con suficientes solicitudes?
No en el sentido en que se copiaría un archivo.
Incluso con cien millones de respuestas, el alumno no recupera automáticamente:
-
los pesos exactos del profesor;
-
sus datos originales de entrenamiento;
-
todas sus capacidades;
-
sus mecanismos internos;
-
todos sus conocimientos;
-
ni exactamente su comportamiento.
La destilación es generalmente selectiva e imperfecta.
Pero no necesita producir un clon perfecto para ser extremadamente rentable.
Supongamos que un competidor dispone ya de un muy buen modelo.
Lo que le falta no es quizás “la inteligencia general” en su conjunto, sino ciertas competencias particulares: programación agente, razonamiento largo, uso de herramientas, ciberseguridad, matemáticas o capacidad para corregir sus propios resultados.
Puede entonces interrogar masivamente un modelo que domina mejor esos dominios, construir un dataset especializado, y concentrar su entrenamiento precisamente donde era débil.
No copia necesariamente a Claude.
Intenta copiar lo que Claude sabe hacer mejor que él.
Y eso es mucho más realista.
Los razonamientos de una IA se han vuelto un recurso estratégico
Los modelos modernos producen a veces mucho más que una respuesta corta.
Para resolver un problema complejo, pueden efectuar cálculos intermedios, probar varios enfoques, usar herramientas, escribir y luego testear código o desarrollar una estrategia sobre una larga secuencia.
Estas trayectorias son extraordinariamente interesantes para entrenar otro sistema.
Es precisamente por esta razón que Anthropic afirma haber reforzado la protección de los razonamientos internos de Claude.
La empresa dice en particular usar resúmenes de razonamiento en lugar de ciertos rastros internos y haber desarrollado protecciones contra técnicas que permiten rejugar firmas de razonamiento entre varias sesiones. Combina eso con clasificadores especializados, análisis de metadatos y peticiones de verificación de identidad cuando un comportamiento parece sospechoso.
Google dice de su lado desarrollar técnicas que permiten reconocer modelos que habrían sido potencialmente destilados desde Gemini, así como defensas capaces de reducir la utilidad de los datos recuperados por un atacante.
La situación se parece cada vez más a una guerra clásica entre atacantes y defensores:
un laboratorio protege sus salidas;
otro encuentra una nueva manera de recuperarlas;
la protección evoluciona;
la extracción cambia de técnica.
Salvo que aquí, el objeto a proteger no es solo un programa.
Es comportamiento.
La API de una IA es también una fuga controlada de competencia
Es probablemente la idea más importante detrás de todo este asunto.
Durante mucho tiempo, proteger un software propietario significaba principalmente proteger su código fuente.
Los grandes modelos cambian ligeramente esta lógica.
Podéis guardar totalmente secretos vuestros pesos, vuestra arquitectura precisa y vuestros datos de entrenamiento.
Para que vuestro modelo tenga un valor comercial, tenéis que permitir sin embargo a los otros ver lo que sabe hacer.
Cada respuesta es, por tanto, una minúscula demostración de competencia.
Aislada, revela casi nada.
A muy gran escala, se vuelve un corpus.
Y ese corpus puede servir para entrenar.
Poner una IA detrás de una API equivale, por tanto, a vender el acceso a su inteligencia intentando impedir que los clientes aprendan lo suficiente para reproducirla.
Es una tensión que no desaparecerá probablemente.
Los investigadores ya la habían identificado con modelos mucho más simples hace diez años. Los modelos actuales han hecho simplemente explotar el valor de lo que puede ser extraído.
Y es ahí donde el debate se vuelve realmente incómodo
Existe algo de bastante irónico en la posición actual de los grandes laboratorios de IA.
Una buena parte de la inteligencia artificial moderna ha sido posible gracias al aprendizaje sobre cantidades gigantescas de datos producidos por otras personas: textos, código, imágenes, discusiones y documentos disponibles en Internet u obtenidos via diferentes licencias y fuentes.
Hoy, las mismas empresas descubren lo desagradable que es ver su propia producción convertirse en material de entrenamiento de otro.
Eso no significa que las dos situaciones sean jurídica o técnicamente idénticas.
No lo son.
Pero la simetría es difícil de ignorar.
Durante años, la pregunta dominante era:
“¿Puede una empresa de IA entrenar su modelo sobre lo que los humanos han producido?”
Una segunda pregunta viene ahora a añadirse:
“¿Puede una empresa de IA entrenar su modelo sobre lo que otra IA ha producido?”
Y, contrariamente a lo que la palabra “destilación” podría dejar pensar, estamos muy lejos de tener una respuesta universal.
La próxima guerra de las IA no concernirá quizás solo a las GPU
Se habla enormemente de chips, de centros de datos, de electricidad y de miles de millones invertidos en el entrenamiento de los modelos.
Todo eso sigue siendo esencial.
Pero un nuevo recurso se vuelve estratégico:
las respuestas producidas por los mejores modelos del mundo.
Porque un laboratorio que no posee el mejor profesor puede, al menos en teoría, intentar alquilar, evadir, automatizar o disimular suficientemente accesos para transformar las competencias en datos.
Los laboratorios dominantes tendrán, por tanto, que defender simultáneamente dos cosas contradictorias:
hacer sus modelos suficientemente accesibles para ser útiles y rentables, mientras impiden a sus competidores acceder a ellos lo suficiente para aprender de ellos.
Anthropic puede banear 5.000 cuentas.
Otras aparecerán.
Google puede detectar cientos de millones de solicitudes automatizadas.
Los ataques pueden repartirse entre más cuentas.
Los modelos pueden enmascarar su razonamiento.
Los extractores pueden buscar otras señales en las salidas finales.
Y cada mejora de un profesor aumenta también el valor potencial de sus lecciones.
La destilación no es, por tanto, una curiosidad técnica.
Está en proceso de convertirse en uno de los nuevos frentes de la competencia mundial en inteligencia artificial.
Y ese frente posee una particularidad fascinante: a diferencia del robo clásico, no es siempre necesario penetrar en la caja fuerte.
A veces, basta con quedarse delante de la puerta, hacer suficientes buenas preguntas… y escuchar atentamente las respuestas.