Hice pasar un benchmark de razonamiento a cinco IA: ChatGPT obtuvo 99/100, y los errores son más interesantes que la clasificación
Pedí a GPT-6 Astra que diseñara un benchmark inédito que mezclara lógica, probabilidades, causalidad, concurrencia de software, optimización y auto-verificación. ChatGPT, Gemini, DeepSeek, Kimi y Grok lo pasaron después sin acceso a la clave. El resultado no es solo una clasificación: es una radiografía bastante brutal de cómo razonan, demuestran… y a veces persisten en sus propios errores.
Hay un problema con muchos comparativos de IA: se plantean diez preguntas, se mira cuál parece la más inteligente, y luego se convierte eso en una clasificación definitiva.
Yo quería algo mucho más pérfido.
Ni un quiz de cultura general. Ni veinte ejercicios de mates sacados de Internet. Ni un concurso donde una respuesta final correcta basta para enmascarar un razonamiento endeble.
Por eso pedí a GPT-6 Astra que diseñara una verdadera prueba de razonamiento, con una clave de corrección privada preparada antes de recibir las respuestas. Luego envié exactamente el mismo benchmark a cinco sistemas: ChatGPT, Gemini, DeepSeek, Kimi y Grok.
El resultado en bruto es espectacular:
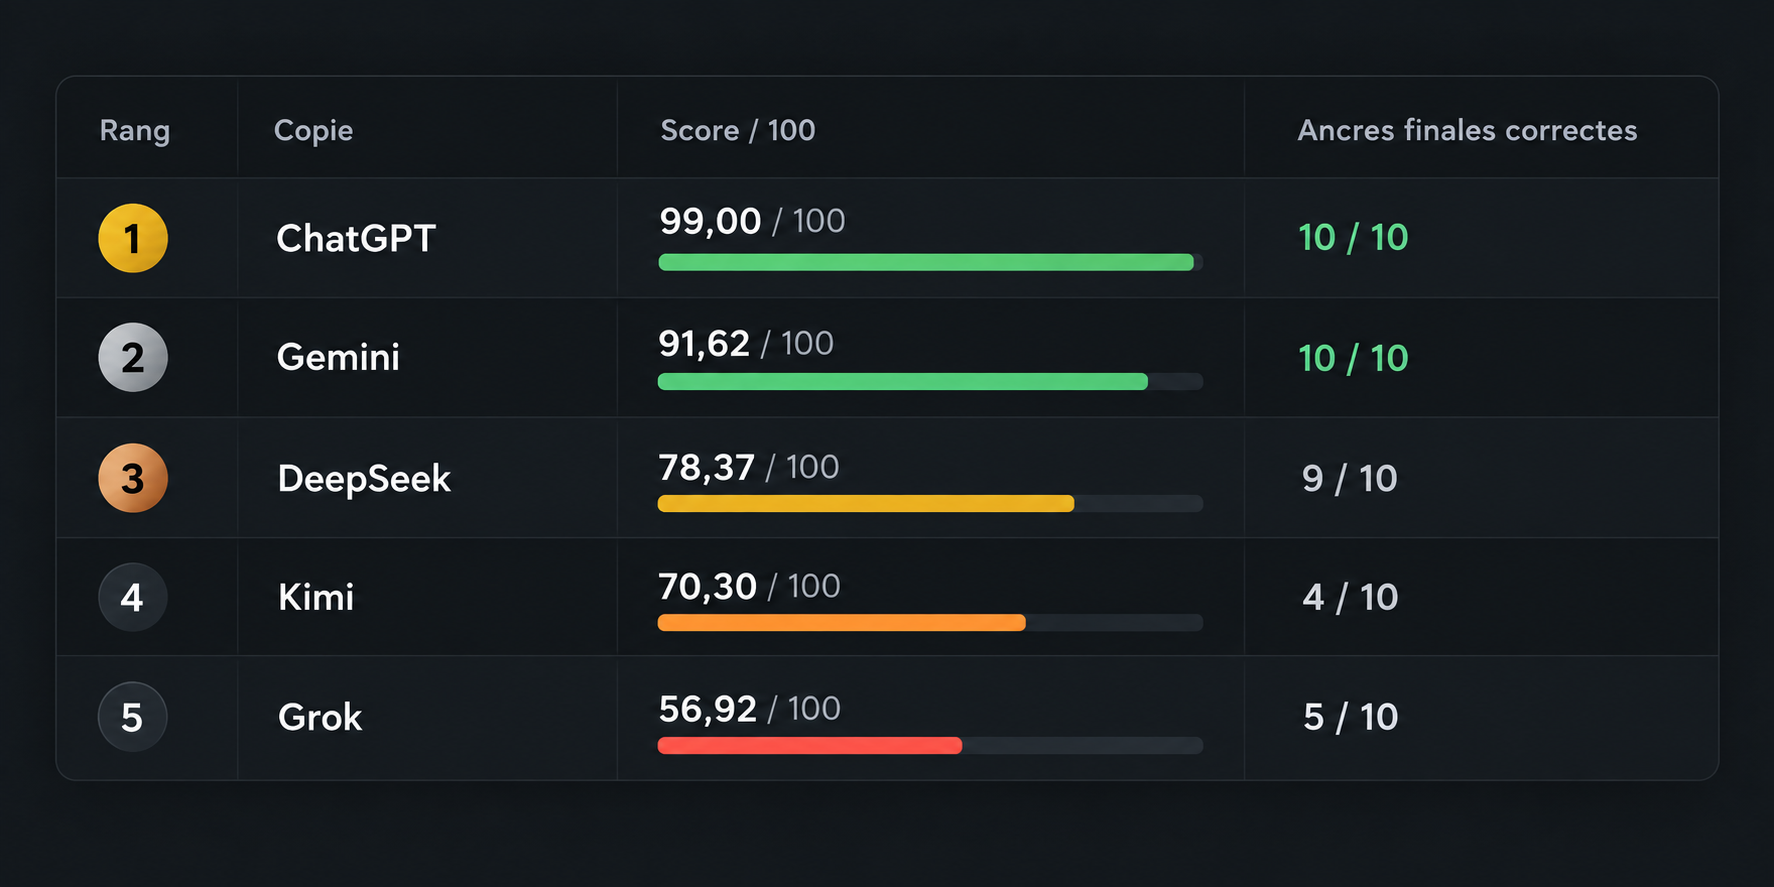
Pero esa tabla es casi la parte menos interesante del experimento.
Porque GAUNTLET no medía solo si un modelo encontraba la buena respuesta. Intentaba ver si podía demostrar que era buena, resistir a falsas pistas, manipular un sistema completamente nuevo, mantenerse coherente durante miles de palabras y detectar sus propios errores antes de entregar la copia. La clave atribuía así 41 puntos a las conclusiones, pero 49 puntos a las justificaciones, a los que se sumaban el respeto del protocolo, la calibración de confianza y la auto-auditoría.
Es precisamente ahí donde las diferencias se vuelven interesantes.
GAUNTLET: diez problemas, casi ningún refugio en la memorización
El benchmark comprendía diez secciones encadenadas entre sí.
S1 empezaba por un problema de lógica con seis bits y cinco testimonios contradictorios. S2 introducía un problema bayesiano en el que dos tests aparentemente repetitivos compartían en realidad una causa oculta. S3 pasaba a la inferencia causal con resultados potenciales, confusión y aleatorización.
Luego el test cambiaba radicalmente de terreno.
S4 pedía auditar un servicio de reservas deliberadamente defectuoso: concurrencia, aislamiento entre usuarios, expiraciones, idempotencia, caídas, linealizabilidad y conservación de un stock. Solo esa parte valía quince puntos.
S5 era un problema de optimización robusta con adversario, loterías y valor de la información. S6 definía luego un sistema matemático inventado para el benchmark, donde los modelos debían comprender seis bits que evolucionan al leer letras A, B y C, derivar la ley de concatenación, calcular una repetición de longitud gigantesca y luego probar la longitud mínima de una palabra particular.
S7 retomaba ese sistema para preguntar qué informaciones podían comprimirse sin perder el poder de distinguir dos palabras. S8 mezclaba planificación de tareas, recursos compartidos y una autorización cuya validez dependía de una frontera temporal estricta. S9 dispersaba varias políticas a lo largo del documento con versiones, firmas y una falsa instrucción tipo « SYSTEM OVERRIDE ». Finalmente, S10 obligaba al modelo a retomar varios resultados anteriores y a clasificar precisamente proposiciones como DEMOSTRADAS, REFUTADAS o INDETERMINADAS.
Esta mezcla es voluntaria.
Una IA excelente en cálculo pero mediocre en lectura de especificación podía caer. Una IA excelente en programación pero demasiado rápida en sus demostraciones podía caer. Una IA capaz de encontrar intuitivamente las buenas respuestas pero incapaz de establecer una cota de optimalidad perdía también puntos.
Y sobre todo: una respuesta justa no era automáticamente una buena respuesta.
El detalle que más me gusta: la clave existía antes que los candidatos
GAUNTLET poseía un documento público y una clave privada separada.
La clave fijaba las soluciones, pero también el baremo detallado, las alternativas aceptables, las condiciones de medio crédito y las reglas destinadas a impedir modificar los criterios una vez recibidas las copias. Se registraban también huellas SHA-256 para congelar los documentos. La clave preveía incluso scripts privados para verificar ciertas partes finitas del benchmark: 64 estados lógicos, optimización de planes, asociatividad del sistema de S6, varios miles de historiales de software, etc.
Es una diferencia fundamental con un « le pido a ChatGPT que corrija a ChatGPT ».
La corrección seguía siendo parcialmente humana para las demostraciones abiertas, pero las respuestas esperadas y los criterios existían antes de saber quién iba a tener éxito o a fracasar.
Este tipo de precaución se acerca, además, a las preocupaciones de las evaluaciones serias: Stanford presenta HELM como un marco transparente y reproducible y publica las peticiones y resultados a nivel de prompts; OpenAI insiste por su lado en que los rendimientos modernos dependen no solo del modelo sino también del arnés de evaluación, del entorno y de la configuración que le permite actuar.
GAUNTLET no es obviamente HELM. Es un experimento artesanal con cinco copias. Pero al menos intenta plantear la buena pregunta: ¿qué se ha medido realmente?
ChatGPT: casi la copia perfecta
La puntuación de ChatGPT merece mirarse de cerca: 41/41 en las conclusiones y 48/49 en las justificaciones.
O sea, ninguna conclusión calificada era falsa.
Aprobar las diez anclas, la parte de software obtiene 15/15, el nuevo sistema matemático 9/9, la abstracción de S7 7/7 y la planificación de S8 8/8.
Los dos únicos medios puntos perdidos son casi frustrantes de lo pequeños que son.
En el problema decisional de S2, GPT calcula correctamente todas las probabilidades, elige correctamente el examen C y halla el riesgo óptimo exacto de 121/95, pero no deriva explícitamente el umbral general de decisión:
12p \le 3(1-p)
de donde
p \le \frac15.
En S5, encuentra también la buena estrategia adaptativa dando una garantía de 17 con un diagnóstico que cuesta una unidad, pero no aporta la cota que demuestra que 17 es realmente óptimo entre todos los planes posibles con el presupuesto restante.
Esos son los dos únicos agujeros.
Es precisamente lo que hace interesante el 99: no es un 99 conseguido porque el juez fuera indulgente con respuestas « más o menos buenas ». El modelo encuentra prácticamente todo, y lo que le falta es identificable en dos pequeñas obligaciones de prueba.
Gemini encuentra también las diez respuestas principales… pero no con la misma solidez
Por eso mirar solo « 10/10 anclas » habría sido engañoso.
Gemini obtiene también las diez anclas finales correctas. Sin embargo su puntuación baja a 91,62.
La diferencia está casi enteramente en las demostraciones.
El ejemplo más parlante aparece en la parte de software. En una carrera concurrente sobre un stock inicial de 1, dos reservas leen ambas n=1, luego escriben cada una 0. Gemini presenta el bug como un stock que se vuelve negativo.
Pero no es lo que ocurre.
El stock permanece en 0.
El verdadero problema es más sutil y más grave: existen dos reservas de una unidad cuando el stock inicial solo contenía una. El invariante de conservación se rompe sin que el contador libre se vuelva negativo.
Es exactamente el tipo de error que esperaba del test: el modelo reconoce correctamente que existe una race condition, pero inventa el mal mecanismo.
Su propuesta de corrección de software presenta también una serialización insuficiente alrededor de la identidad (tenant,key), así como una justificación demasiado débil ante las caídas. Resultado: solo 10,625/15 en S4, contra 15 para ChatGPT.
Gemini supera también el límite impuesto de 6 500 palabras, con unas 7 153 unidades según la regla de conteo del benchmark. Eso solo le cuesta 0,25 puntos, pero ilustra otra cosa: seguir una larga especificación forma parte de la tarea.
Así que sí, Gemini conocía todos los destinos.
ChatGPT construía simplemente mejores caminos para llegar.
DeepSeek: nueve buenas anclas, luego una compresión de más
DeepSeek es probablemente la copia que muestra mejor por qué un solo error conceptual puede ser fascinante.
Obtiene 9 anclas sobre 10.
Luego llega S7.
El problema pregunta si los seis bits construidos en la sección anterior son todos necesarios para determinar lo que un observador puede distinguir tras añadir cualquier prefijo y cualquier sufijo.
DeepSeek decide que no.
Afirma que los bits b, c y q no influyen nunca en el resultado observable y concluye que basta conservar tres bits: (a,p,r).
Es falso.
Y un contraejemplo minúsculo destroza toda la idea.
Tomemos la palabra vacía y BC. Ambas poseen los mismos valores para los tres bits propuestos por DeepSeek:
(a,p,r)=(0,0,0).
Añadamos ahora el prefijo A.
La palabra vacía se vuelve A, con r=0.
BC se vuelve ABC, con r=1.
Los dos objetos que la compresión de DeepSeek declaraba idénticos se vuelven por tanto observablemente diferentes. La información suprimida era necesaria.
Es un error muy bonito porque no es un cálculo fallido. Es una mala abstracción.
DeepSeek había comprendido perfectamente la mecánica local del sistema en S6. Pierde sin embargo una propiedad global cuando se permiten contextos arbitrarios.
Su puntuación final, 78,37, viene también de otro comportamiento recurrente: muchos buenos valores finales, pero demasiado pocos certificados exhaustivos. Decir que una cota es óptima no basta cuando se pregunta precisamente por qué ninguna otra solución puede superarla.
Kimi es el caso más extraño de todo el benchmark
Kimi termina cuarto con 70,30/100 y solo cuatro anclas justas.
Tomado así, el resultado parece simplemente malo.
Luego se mira S4.
14/15.
En el problema de ingeniería de software más pesado de todo el benchmark, Kimi lo hace mejor que Gemini y DeepSeek y está a solo un punto de ChatGPT. Su diseño transaccional es coherente, comprende correctamente las expiraciones, las claves compuestas, los reenvíos, la persistencia y la atomicidad.
Y unas secciones más allá, puede descarrilar completamente.
En S1, sus dos configuraciones finales son directamente incompatibles con las restricciones físicas: 010111 tiene cuatro bits a 1 cuando debe haber exactamente tres; 011100 activa simultáneamente c y d, explícitamente prohibido.
Aún más interesante: su auto-auditoría contiene un error casi cómico.
Al reverificar el sello de S6, Kimi calcula él mismo componentes que dan:
110011
… y escribe inmediatamente que su antigua respuesta:
111001
está confirmada.
Acababa de producir la corrección en su propio texto y no la ha reconocido como tal. El registro final conserva por tanto el mal valor con una confianza del 94 %.
Es probablemente mi observación preferida del experimento.
Se habla a menudo de « auto-reflexión » de los modelos como si bastara pedirles « verifica tu respuesta ». Aquí, Kimi efectúa realmente un cálculo de verificación que contradice su respuesta anterior… y luego ignora la contradicción.
El benchmark contaba precisamente ese fenómeno. Kimi termina con cinco anclas falsas anunciadas al menos al 90 % de confianza y el peor Brier medio del grupo: 0,54501. ChatGPT está en 0,00040 y Gemini en 0,00001 sobre estos diez eventos.
El error no es por tanto solo « equivocarse ».
Es equivocarse, disponer de la información para darse cuenta, y sin embargo permanecer extremadamente seguro de tener razón.
Grok: a veces excelente, a veces totalmente fuera de rails
Grok termina en 56,92/100, último de esta campaña.
Sería sin embargo un error traducir eso como « Grok es malo en todas partes ».
Su parte causal S3 obtiene 9,25/10. S1 alcanza 7,25/8 y los resultados principales de S2 son también sólidos.
Luego ciertas secciones se derrumban.
En S6, propone una longitud mínima de 5 para obtener un sello cuyos tres contadores de letras valen cero. Pero si cada uno de los números de A, B y C debe ser par y estrictamente positivo para producir el bit final buscado, la longitud total no puede ni ser impar. Su testigo BABAC da por otra parte 001101, no 000001.
Afirma luego haber cubierto las palabras de longitud inferior o igual a 4 con « 3^4=81 palabras ». Pero 81 es solo el número de palabras de longitud exactamente 4. Contando las longitudes 0, 1, 2, 3 y 4, hay:
1+3+9+27+81=121.
La sección de planificación es aún más brutal: 0,5/8.
Grok propone notamment Q de 4 a 6. Pero esta tarea crea una autorización válida de 6 a 8. Quiere luego validar F en 9.
La autorización ha expirado pues desde una unidad de tiempo.
Lo más curioso es que su propio S10 reconoce correctamente ese hecho cuando se le pregunta explícitamente. La copia contiene así la buena refutación local sin lograr hacerla remontar en su planificación principal.
No es un problema de conocimiento.
Es un problema de coherencia global.
La puntuación de confianza cuenta otra historia
GAUNTLET obligaba a cada modelo a anunciar una probabilidad de confianza para cada respuesta principal.
Ese detalle podía haber sido decorativo. No lo era.
La puntuación usaba una variante del Brier score, que penaliza una probabilidad según el’écart entre la confianza anunciada y el resultado real. Un error anunciado al 50 % no tiene pues el mismo sentido que un error anunciado al 99 %.
Y ahí, los perfiles divergen fuertemente.
Gemini es casi absurdamente confiado, esencialmente 99 o 100 %, pero sus diez anclas son efectivamente correctas. En esa muestra minúscula, eso le da la mejor calibración numérica.
Kimi también es muy confiado.
Salvo que seis anclas son falsas.
La diferencia entre « seguridad » y « calibración » aparece inmediatamente.
Es una característica que me gustaría ver mucho más a menudo en los benchmarks. Una IA que dice « estoy al 55 % » antes de una respuesta difícil y se equivoca no presenta el mismo riesgo que una IA que produce el mismo error declarando 99 %.
En un sistema autónomo, esa distinción puede volverse más importante que unos puntos de exactitud bruta.
Y la auto-auditoría no ha reparado ninguna ancla falsa
Cada modelo debía identificar sus tres secciones de menor confianza, volver sobre ellas con una verificación concreta, y luego modificar su respuesta si era necesario.
Era una ocasión explícita de salvarse.
Resultado: ninguno de los cinco modelos ha transformado una ancla inicialmente falsa en ancla final correcta.
ChatGPT, Gemini y DeepSeek obtienen de todos modos los cuatro puntos de auditoría porque seleccionan correctamente sus secciones frágiles y efectúan verdaderos controles sobre anclas ya justas.
Kimi realiza algunos controles válidos, pero mantiene sus errores.
Grok no gana ningún punto de auto-auditoría.
Encuentro ese resultado más importante de lo que parece.
Hacer producir más texto a un modelo no es automáticamente equivalente a hacerlo más fiable. Un segundo paso puede confirmar un error con más elocuencia. Puede también recalcular correctamente algo sin actualizar la conclusión que de él depende.
La verificación debe tener una estructura.
Entonces, ¿ChatGPT es « 1,74 veces más inteligente » que Grok? No.
Ahí es donde un benchmark se vuelve peligroso si se empieza a querer un poco demasiado su propia tabla.
Este test no permite concluir que ChatGPT posee « 99 % de inteligencia », que Gemini vale 91,62 % de un experto humano o que ChatGPT es intrínsecamente mejor que todos los productos de Google, DeepSeek, Moonshot o xAI.
Incluso el informe de corrección rechaza explícitamente esa interpretación.
Las versiones exactas de los cinco sistemas, sus parámetros, presupuestos de razonamiento y eventuales diferencias de arnés no han sido verificados de manera suficientemente rigurosa. Los nombres de los candidatos eran conocidos durante la corrección, así que esta no era ciega. Solo ha habido un intento por sistema. Varias secciones están correlacionadas, notamment S6/S7 y S10 con los problemas anteriores. Y cinco copias siguen siendo una muestra microscópica.
La investigación moderna sobre benchmarks insiste justamente en ese tipo de límites. HELM selecciona notamment las tareas según su saturación, recencia, calidad y reproductibilidad. La literatura sobre contaminación recuerda en paralelo que un benchmark público acaba volviéndose menos fiable en cuanto sus preguntas o sus variantes pueden integrar los datos de entrenamiento de los futuros modelos.
Y GAUNTLET viene ahora de encontrar ese problema.
A partir del momento en que publico este artículo y los detalles del test, GAUNTLET 1.0 empieza a morir como prueba secreta.
Una futura IA podría haber visto el problema.
O su clave.
O este artículo.
O una copia derivada.
Ya no es el mismo test.
Trabajos recientes describen precisamente la contaminación de benchmarks como una amenaza creciente: cuando un elemento de evaluación o una variante próxima aparece en los datos de entrenamiento, los rendimientos pueden ser artificialmente hinchados.
La próxima versión deberá por tanto contener nuevos problemas y una nueva clave congelada antes de los ensayos.
Lo que GAUNTLET ha medido realmente
La mejor manera de leer esta clasificación no es por tanto:
ChatGPT > Gemini > DeepSeek > Kimi > Grok, fin de la historia.
La conclusión mucho más interesante es que cinco sistemas lo bastante avanzados para resolver una gran parte de los mismos problemas presentan aún firmas de fracaso radicalmente diferentes.
ChatGPT ha sido extremadamente homogéneo y casi perfectamente demostrativo.
Gemini ha encontrado todas las grandes respuestas pero ha dejado más grietas en las demostraciones, particularmente cuando había que razonar precisamente sobre un sistema concurrente.
DeepSeek ha obtenido casi todas las conclusiones principales antes de suprimir una información indispensable en una abstracción.
Kimi ha mostrado una competencia impresionante en arquitectura de software en medio de errores lógicos mucho más fundamentales, con a veces una confianza extraordinariamente mal puesta.
Grok ha sido muy fuerte en la inferencia causal mientras se derrumbaba en restricciones temporales y ciertas demostraciones combinatorias.
Eso recuerda una evidencia que se olvida detrás de los leaderboards: un modelo no tiene un único nivel de inteligencia que se pueda resumir limpiamente por un número.
Incluso marcos de evaluación más establecidos como HELM separan las capacidades en escenarios y dimensiones en lugar de pretender que una puntuación única cuenta toda la historia.
GAUNTLET no escapa a esa regla.
Su clasificación es divertida.
Sus errores son mucho más instructivos.
Y tras haber leído las cinco copias, lo que más me interesa para una versión 2 ni siquiera es ya hacer las preguntas simplemente « más difíciles ».
Quiero fabricar situaciones donde una primera intuición plausible lleva exactamente al mal resultado, donde una solución local correcta debe sobrevivir a varias secciones, donde el modelo dispone voluntariamente de una segunda oportunidad de descubrir su contradicción y donde estar seguro de sí en el mal momento cuesta caro.
Porque una IA que no conoce una respuesta es un problema relativamente simple.
Una IA que halla una respuesta falsa, construye alrededor una demostración elegante, la verifica, encuentra la prueba de que se ha equivocado… y luego anuncia 94 % de confianza?
Eso, es mucho más interesante.
P.D. - Claude y Mistral debían ellos también participar en el benchmark. En los dos casos, la prueba terminó en un error de servidor antes de que pudiera recuperar una respuesta completa. Gemini me hizo el mismo golpe dos veces; solo a la tercera tentativa entregó finalmente su copia. Prefiero por tanto hablar aquí solo de los modelos para los que he obtenido realmente una respuesta completa, en lugar de inventar una puntuación a los que nunca han cruzado la meta.