Ich ließ fünf KI-Systeme einen Reasoning-Benchmark absolvieren: ChatGPT erzielte 99/100, und die Fehler sind interessanter als die Rangliste
Ich bat GPT-6 Astra, einen neuartigen Benchmark zu entwerfen, der Logik, Wahrscheinlichkeiten, Kausalität, Software-Konkurrenz, Optimierung und Selbstverifikation vereint. ChatGPT, Gemini, DeepSeek, Kimi und Grok absolvierten ihn anschließend ohne Zugriff auf die Lösung. Das Ergebnis ist nicht nur eine Rangliste: Es ist eine ziemlich schonungslose Röntgenaufnahme dessen, wie diese Modelle denken, beweisen … und manchmal in ihren eigenen Fehlern verharren.
Bei vielen KI-Vergleichen gibt es ein Problem: Man stellt zehn Fragen, schaut, welche am intelligentesten wirkt, und macht daraus ein finales Ranking.
Ich wollte etwas deutlich gemeineres.
Kein Allgemeinwissens-Quiz. Keine zwanzig Mathe-Aufgaben aus dem Netz. Kein Wettbewerb, bei dem eine richtige Endantwort einen wackeligen Gedankengang überdeckt.
Also bat ich GPT-6 Astra, eine echte Reasoning-Prüfung zu entwerfen, mit einem privaten Korrekturschlüssel, der vor Erhalt der Antworten erstellt wurde. Dann schickte ich exakt denselben Benchmark an fünf Systeme: ChatGPT, Gemini, DeepSeek, Kimi und Grok.
Das rohe Ergebnis ist spektakulär:
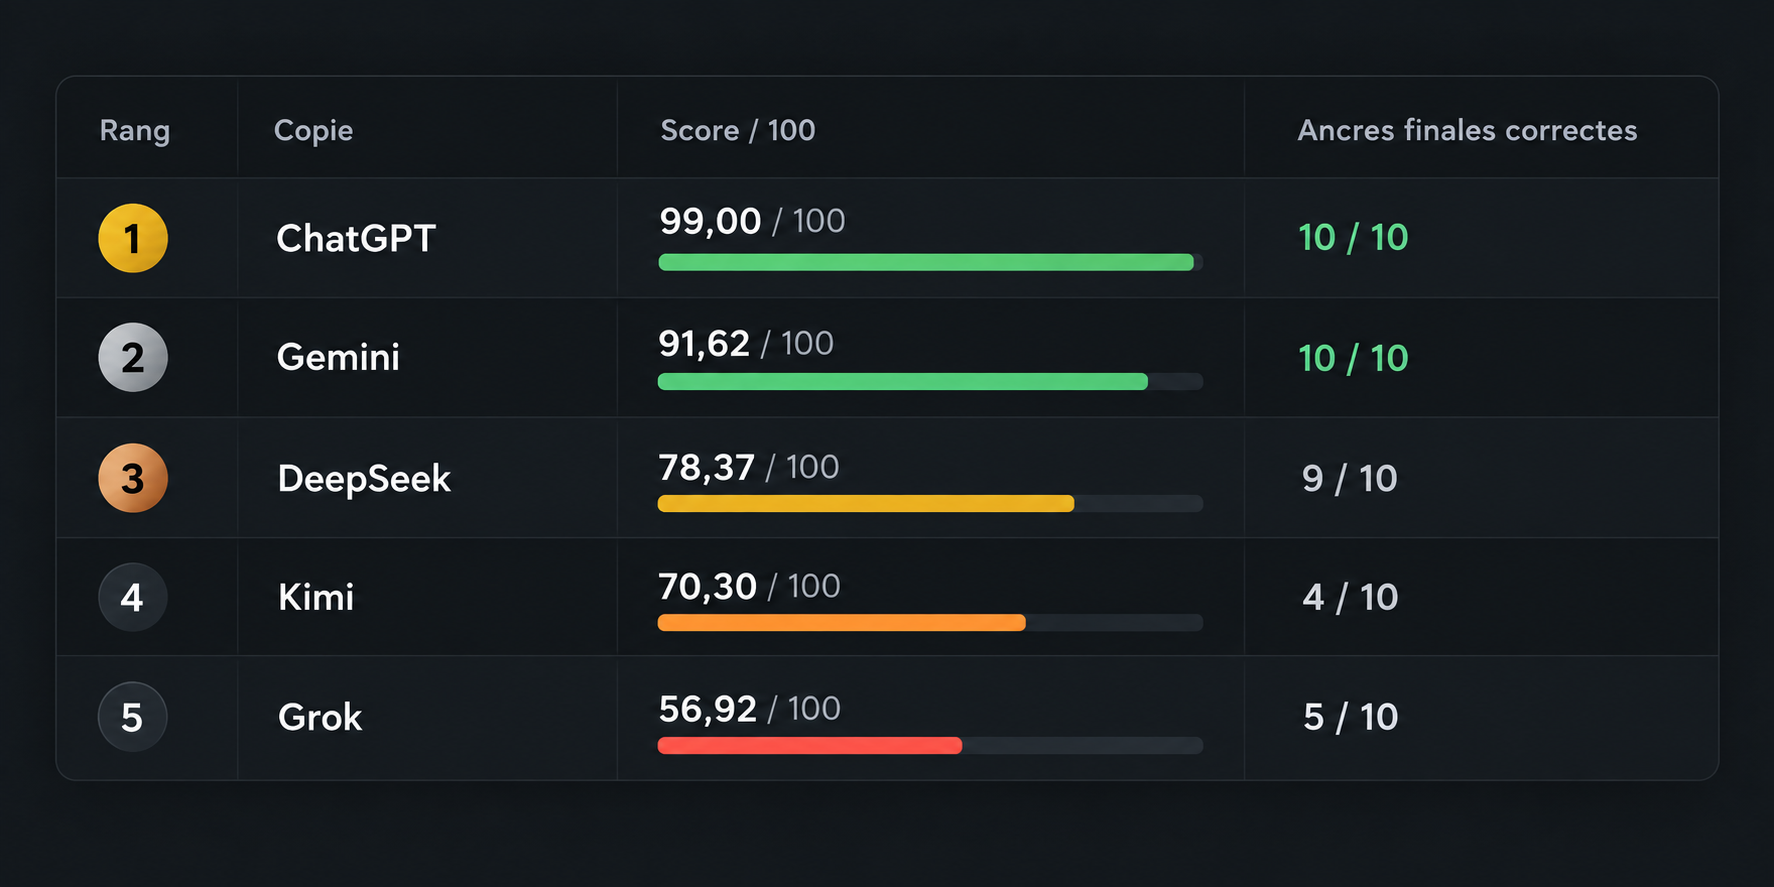
Doch diese Tabelle ist fast der uninteressanteste Teil des Experiments.
Denn GAUNTLET maß nicht nur, ob ein Modell die richtige Antwort fand. Es versuchte zu sehen, ob es beweisen konnte, dass sie richtig war, falschen Finten widerstand, ein völlig neues System manipulieren konnte, über tausende Wörter hinweg kohärent blieb und seine eigenen Fehler erkannte, bevor es die Arbeit abgab. Der Korrekturschlüssel vergab so 41 Punkte für die Schlussfolgerungen, aber 49 Punkte für die Begründungen, dazu kamen Protokolltreue, Konfidenzkalibrierung und Selbst-Audit.
Genau dort werden die Unterschiede interessant.
GAUNTLET: zehn Probleme, kaum Zuflucht in Memorisierung
Der Benchmark bestand aus zehn miteinander verknüpften Abschnitten.
S1 begann mit einem Logikproblem: sechs Bits, fünf widersprüchliche Zeugenaussagen. S2 führte ein Bayes-Problem ein, in dem zwei scheinbar repetitive Tests tatsächlich eine verborgene gemeinsame Ursache teilten. S3 wechselte zur kausalen Inferenz mit potenziellen Ergebnissen, Confounding und Randomisierung.
Dann wechselte das Terrain grundlegend.
S4 verlangte das Audit eines absichtlich fehlerhaften Buchungsservices: Konkurrenz, Isolation zwischen Nutzern, Timeouts, Idempotenz, Abstürze, Linearisierbarkeit und Erhalt eines Bestands. Allein dieser Teil war fünfzehn Punkte wert.
S5 war ein robustes Optimierungsproblem mit Adversär, Lotterien und Informationswert. S6 definierte anschließend ein für den Benchmark erfundenes mathematisches System, in dem die Modelle sechs Bits verstehen mussten, die sich bei der Lektüre der Buchstaben A, B, C entwickeln, das Konkatenationsgesetz herleiten, eine riesige Wiederholung berechnen und dann die minimale Länge eines bestimmten Wortes beweisen mussten.
S7 griff dieses System wieder auf und fragte, welche Informationen sich komprimieren lassen, ohne die Unterscheidungskraft zwischen zwei Wörtern zu verlieren. S8 mischte Task-Scheduling, geteilte Ressourcen und eine Berechtigung, deren Gültigkeit von einer strikten Zeitgrenze abhing. S9 verstreute mehrere Policies im Dokument mit Versionen, Signaturen und einer gefälschten Anweisung vom Typ „SYSTEM OVERRIDE“. Schließlich zwang S10 das Modell, mehrere frühere Ergebnisse aufzugreifen und präzise einzustufen, ob Aussagen BEWIESEN, WIDERLEGT oder UNBESTIMMT sind.
Diese Mischung ist Absicht.
Eine KI, die im Rechnen glänzt, aber Spezifikationen schlecht liest, kann scheitern. Eine KI, die programmieren kann, aber in Beweisen zu schnell ist, kann scheitern. Eine KI, die intuitiv die richtigen Antworten findet, aber keine Optimalitätsschranke herleiten kann, verliert ebenfalls Punkte.
Und vor allem: Eine richtige Antwort war nicht automatisch eine gute Antwort.
Das Detail, das mir am besten gefällt: Der Korrekturschlüssel existierte vor den Kandidaten
GAUNTLET besaß ein öffentliches Dokument und einen separaten privaten Schlüssel.
Der Schlüssel legte die Lösungen fest, aber auch das detaillierte Bewertungsschema, akzeptable Alternativen, Halbpunkt-Regeln und Vorschriften, die verhinderten, die Kriterien nach Erhalt der Arbeiten zu ändern. SHA-256-Hashes wurden ebenfalls hinterlegt, um die Dokumente einzufrieren. Der Schlüssel enthielt sogar private Skripte zur Verifikation bestimmter endlicher Teile des Benchmarks: 64 logische Zustände, Plan-Optimierung, Assoziativität des Systems aus S6, mehrere tausend Software-Historien etc.
Das ist ein fundamentaler Unterschied zu „ich bitte ChatGPT, ChatGPT zu bewerten“.
Die Korrektur blieb für offene Beweise teilweise menschlich, aber die erwarteten Antworten und Kriterien existierten bevor man wusste, wer bestehen oder durchfallen würde.
Solche Vorsichtsmaßnahmen spiegeln auch die Bedenken seriöser Evaluationen wider: Stanford präsentiert HELM als transparenten, reproduzierbaren Rahmen und veröffentlicht Prompts und Ergebnisse auf Prompt-Ebene; OpenAI betont seinerseits, dass moderne Performance nicht nur vom Modell abhängt, sondern auch vom Evaluation-Harness, der Umgebung und der Konfiguration, die ihm Handlungsfähigkeit verleihen.
GAUNTLET ist offensichtlich nicht HELM. Es ist ein handwerkliches Experiment mit fünf Arbeiten. Aber zumindest stellt es die richtige Frage: Was wurde tatsächlich gemessen?
ChatGPT: fast die perfekte Arbeit
ChatGPTs Score verdient genaue Betrachtung: 41/41 bei den Schlussfolgerungen und 48/49 bei den Begründungen.
Mit anderen Worten: Keine bewertete Schlussfolgerung war falsch.
Es meistert alle zehn Anker, der Software-Teil erhält 15/15, das neue mathematische System 9/9, die Abstraktion in S7 7/7 und das Planning in S8 8/8.
Die einzigen beiden halben Punkte, die fehlen, sind fast frustrierend klein.
Im Entscheidungsproblem von S2 berechnet GPT alle Wahrscheinlichkeiten korrekt, wählt korrekt Test C und findet das exakte optimale Risiko von 121/95, leitet aber den allgemeinen Entscheidungsschwellenwert nicht explizit her:
12p \le 3(1-p)
daher
p \le \frac15.
In S5 findet es ebenfalls die richtige adaptive Strategie mit einer Garantie von 17 bei Kosten von einer Einheit für die Diagnose, liefert aber nicht die Schranke, die beweist, dass 17 tatsächlich optimal unter allen möglichen Plänen mit dem verbleibenden Budget ist.
Das sind die einzigen zwei Lücken.
Genau das macht die 99 interessant: Es ist keine 99, die entsteht, weil der Korrektor bei „fast richtigen“ Antworten großzügig war. Das Modell findet praktisch alles, und was fehlt, lässt sich auf zwei winzige Beweisverpflichtungen eingrenzen.
Gemini findet ebenfalls alle zehn Hauptantworten … aber nicht mit derselben Solidität
Deshalb wäre es irreführend, nur auf „10/10 Anker“ zu schauen.
Gemini erreicht ebenfalls alle zehn finalen Anker korrekt. Doch sein Score sinkt auf 91,62.
Der Unterschied liegt fast vollständig in den Begründungen.
Das sprechendste Beispiel erscheint im Software-Teil. Bei einem konkurrierenden Lauf auf einem Initialbestand von 1 lesen zwei Buchungen beide n=1, dann schreiben sie jeweils 0. Gemini beschreibt den Bug als negativ werdenden Bestand.
Aber das passiert nicht.
Der Bestand bleibt 0.
Das echte Problem ist subtiler und gravierender: Zwei Buchungen zu je einer Einheit existieren, obwohl der Initialbestand nur eine enthielt. Der Erhaltungsinvariant ist gebrochen, ohne dass der freie Zähler negativ wird.
Genau das ist der Fehlertyp, den der Test provozieren sollte: Das Modell erkennt korrekt, dass eine Race Condition vorliegt, erfindet aber den falschen Mechanismus.
Sein Korrekturvorschlag zeigt zudem eine unzureichende Serialisierung um die Identität (tenant,key) und eine zu schwache Begründung gegenüber Abstürzen. Ergebnis: nur 10,625/15 in S4, gegenüber 15 bei ChatGPT.
Gemini überschreitet auch das vorgegebene Limit von 6 500 Wörtern, mit ca. 7 153 Einheiten nach der Zählregel des Benchmarks. Das kostet nur 0,25 Punkte, illustriert aber etwas anderes: Das Befolgen einer langen Spezifikation ist Teil der Aufgabe.
Also ja, Gemini kannte alle Ziele.
ChatGPT baute einfach bessere Wege dorthin.
DeepSeek: neun richtige Anker, dann eine Kompression zu viel
DeepSeek ist wahrscheinlich die Arbeit, die am besten zeigt, warum ein einziger konzeptioneller Fehler faszinierend sein kann.
Es erreicht 9 von 10 Ankern.
Dann kommt S7.
Die Frage: Sind die sechs Bits aus dem vorigen Abschnitt alle notwendig, um zu bestimmen, was ein Beobachter nach Hinzufügen beliebiger Präfixe und Suffixe unterscheiden kann?
DeepSeek entscheidet: Nein.
Es behauptet, die Bits b, c und q beeinflussten das beobachtbare Ergebnis nie und schließt, dass drei Bits genügen: (a,p,r).
Das ist falsch.
Und ein winziges Gegenbeispiel zerstört die ganze Idee.
Nehmen wir das leere Wort und BC. Beide haben dieselben Werte für die drei von DeepSeek vorgeschlagenen Bits:
(a,p,r)=(0,0,0).
Fügen wir nun das Präfix A hinzu.
Das leere Wort wird zu A, mit r=0.
BC wird zu ABC, mit r=1.
Die beiden Objekte, die DeepSeeks Kompression für identisch erklärte, werden also beobachtbar unterschiedlich. Die gelöschte Information war notwendig.
Das ist ein sehr schöner Fehler, weil es kein verpatzter Rechenweg ist. Es ist eine schlechte Abstraktion.
DeepSeek hatte die lokale Mechanik des Systems in S6 perfekt verstanden. Es verliert aber eine globale Eigenschaft, sobald beliebige Kontexte erlaubt sind.
Sein Endscore, 78,37, rührt auch von einem anderen wiederkehrenden Verhalten her: Viele richtige Endwerte, aber zu wenig exhaustive Zertifikate. Zu sagen, eine Schranke sei optimal, reicht nicht, wenn explizit gefragt wird, warum keine andere Lösung sie übertreffen kann.
Kimi ist der seltsamste Fall des ganzen Benchmarks
Kimi landet auf Platz vier mit 70,30/100 und nur vier richtigen Ankern.
So betrachtet wirkt das Ergebnis einfach schlecht.
Dann schaut man auf S4.
14/15.
Beim schwersten Software-Engineering-Problem des gesamten Benchmarks schneidet Kimi besser ab als Gemini und DeepSeek und liegt nur einen Punkt hinter ChatGPT. Sein Transaktionsdesign ist kohärent, er versteht Timeouts, Composite Keys, Replays, Persistenz und Atomicity korrekt.
Und wenige Abschnitte später kann er komplett entgleisen.
In S1 sind seine beiden finalen Konfigurationen schlicht unvereinbar mit den physikalischen Constraints: 010111 hat vier Bits auf 1, wo genau drei sein müssen; 011100 aktiviert c und d gleichzeitig, was explizit verboten ist.
Noch interessanter: Sein Selbst-Audit enthält einen fast komischen Fehler.
Beim Re-Check des Siegels von S6 berechnet Kimi selbst Komponenten, die ergeben:
110011
… und schreibt sofort, seine frühere Antwort:
111001
sei bestätigt.
Er hatte die Korrektur gerade in seinem eigenen Text produziert und sie nicht als solche erkannt. Der finale Register behält also den falschen Wert bei 94 % Konfidenz.
Das ist wohl meine Lieblingsbeobachtung des Experiments.
Oft redet man von „Selbstreflexion“ der Modelle, als reiche es, sie zu fragen: „Prüf deine Antwort“. Hier führt Kimi tatsächlich eine Verifikationsrechnung durch, die seine eigene vorherige Antwort widerspricht … und ignoriert den Widerspruch.
Der Benchmark erfasste genau dieses Phänomen. Kimi endet mit fünf falschen Ankern, die mit mindestens 90 % Konfidenz angekündigt wurden, und dem schlechtesten mittleren Brier-Score der Gruppe: 0,54501. ChatGPT liegt bei 0,00040 und Gemini bei 0,00001 für diese zehn Ereignisse.
Der Fehler ist also nicht nur „falsch liegen“.
Es ist falsch liegen, die Information zur Korrektur zu besitzen, und dann extrem sicher sein, recht zu haben.
Grok: mal ausgezeichnet, mal völlig neben der Spur
Grok schließt mit 56,92/100 ab, letzter in diesem Durchgang.
Doch wäre es ein Fehler, das als „Grok ist überall schlecht“ zu lesen.
Sein kausaler Teil S3 erreicht 9,25/10. S1 schafft 7,25/8 und die Hauptergebnisse von S2 sind ebenfalls solide.
Dann brechen bestimmte Abschnitte zusammen.
In S6 schlägt er eine Minimallänge von 5 für ein Siegel vor, dessen drei Buchstabenzähler null wert sind. Wenn aber jede der Anzahlen von A, B und C gerade und streng positiv sein muss, um das gesuchte finale Bit zu erzeugen, kann die Gesamtlänge gar nicht ungerade sein. Sein Zeuge BABAC liefert zudem 001101, nicht 000001%.
Er behauptet dann, Wörter der Länge ≤ 4 mit „3^4=81 Wörter“ abgedeckt zu haben. Aber 81 ist nur die Zahl der Wörter der Länge exakt 4. Zählt man Längen 0, 1, 2, 3 und 4, sind es:
1+3+9+27+81=121.
Der Planning-Teil ist noch brutaler: 0,5/8.
Grok schlägt unter anderem Q von 4 bis 6 vor. Diese Task erzeugt aber eine Berechtigung, die von 6 bis 8 gültig ist. Er will dann F bei 9 validieren.
Die Berechtigung ist also seit einer Zeiteinheit abgelaufen.
Das Kurioseste: Sein eigenes S10 erkennt diesen Umstand korrekt, wenn man ihn explizit fragt. Die Arbeit enthält also die richtige lokale Widerlegung, ohne dass sie in den Hauptplan einfließt.
Das ist kein Wissensproblem.
Es ist ein globales Kohärenzproblem.
Der Konfidenz-Score erzählt eine andere Geschichte
GAUNTLET zwang jedes Modell, für jede Hauptantwort eine Konfidenzwahrscheinlichkeit anzugeben.
Das Detail hätte dekorativ sein können. War es nicht.
Der Score nutzte eine Variante des Brier-Scores, der eine Wahrscheinlichkeit nach dem Abstand zwischen angekündigter Konfidenz und realem Ergebnis bestraft. Ein Fehler bei 50 % hat also nicht dieselbe Bedeutung wie einer bei 99 %.
Und hier divergieren die Profile stark.
Gemini ist fast absurd selbstsicher – im Wesentlichen 99 oder 100 % – aber seine zehn Anker sind tatsächlich korrekt. Auf dieser winzigen Stichprobe erhält es die beste numerische Kalibrierung.
Kimi ist ebenfalls sehr selbstsicher.
Aber sechs Anker sind falsch.
Der Unterschied zwischen „Selbstsicherheit“ und „Kalibrierung“ wird sofort sichtbar.
Das ist eine Eigenschaft, die ich in Benchmarks viel häufiger sehen möchte. Eine KI, die vor einer schweren Antwort „ich bin zu 55 %“ sagt und sich irrt, stellt nicht dasselbe Risiko dar wie eine KI, die denselben Fehler bei 99 % Verkündung begeht.
In einem autonomen System kann diese Unterscheidung wichtiger werden als einige Rohgenauigkeitspunkte.
Und das Selbst-Audit hat keinen falschen Anker repariert
Jedes Modell sollte seine drei unsichersten Abschnitte identifizieren, sie mit einer konkreten Verifikation erneut prüfen und die Antwort gegebenenfalls ändern.
Das war eine explizite Chance zur Rettung.
Ergebnis: Keines der fünf Modelle verwandelte einen initial falschen Anker in einen final korrekten.
ChatGPT, Gemini und DeepSeek erhalten dennoch die vier Audit-Punkte, weil sie ihre schwachen Abschnitte korrekt wählen und echte Kontrollen an bereits richtigen Ankern durchführen.
Kimi führt einige gültige Kontrollen durch, behält aber seine Fehler bei.
Grok holt keinen Audit-Punkt.
Ich finde dieses Ergebnis wichtiger, als es scheint.
Ein Modell mehr Text produzieren zu lassen, macht es nicht automatisch zuverlässiger. Ein zweiter Durchgang kann einen Fehler mit mehr Eloquenz bestätigen. Er kann auch etwas korrekt neu berechnen, ohne die davon abhängige Schlussfolgerung zu aktualisieren.
Verifikation muss Struktur haben.
Also, ist ChatGPT „1,74-mal intelligenter“ als Grok? Nein.
Genau hier wird ein Benchmark gefährlich, wenn man anfängt, seine eigene Tabelle zu sehr zu mögen.
Dieser Test erlaubt nicht den Schluss, ChatGPT besitze „99 % Intelligenz“, Gemini entspreche 91,62 % eines menschlichen Experten oder ChatGPT sei intrinsisch besser als alle Produkte von Google, DeepSeek, Moonshot oder xAI.
Selbst der Korrekturbericht verweigert diese Interpretation explizit.
Die exakten Versionen der fünf Systeme, ihre Parameter, Reasoning-Budgets und eventuelle Harness-Unterschiede wurden nicht hinreichend rigoros verifiziert. Die Kandidatennamen waren während der Korrektur bekannt, also war sie nicht blind. Es gab nur einen Versuch pro System. Mehrere Abschnitte sind korreliert, insbesondere S6/S7 und S10 mit den Vorproblemen. Und fünf Arbeiten bleiben eine mikroskopische Stichprobe.
Die moderne Benchmark-Forschung besteht gerade auf solchen Limitationen. HELM wählt Tasks u. a. nach Sättigung, Aktualität, Qualität und Reproduzierbarkeit aus. Die Literatur zur Kontamination erinnert parallel daran, dass ein öffentlicher Benchmark weniger verlässlich wird, sobald seine Fragen oder Varianten in die Trainingsdaten künftiger Modelle eingehen können.
Und GAUNTLET begegnet jetzt genau diesem Problem.
Ab dem Moment, wo ich diesen Artikel und die Testdetails veröffentliche, beginnt GAUNTLET 1.0 als geheime Prüfung zu sterben.
Eine zukünftige KI könnte das Problem gesehen haben.
Oder seine Lösung.
Oder diesen Artikel.
Oder eine abgeleitete Kopie.
Es ist nicht mehr derselbe Test.
Neuere Arbeiten beschreiben Benchmark-Kontamination präzise als wachsende Bedrohung: Wenn ein Evaluationselement oder eine naheliegende Variante in den Trainingsdaten auftaucht, können Performances künstlich aufgebläht werden.
Die nächste Version muss daher neue Probleme und einen neuen, vor den Versuchen eingefrorenen Schlüssel enthalten.
Was GAUNTLET tatsächlich gemessen hat
Die beste Art, dieses Ranking zu lesen, ist also nicht:
ChatGPT > Gemini > DeepSeek > Kimi > Grok, Ende der Geschichte.
Die weit interessantere Schlussfolgerung ist, dass fünf Systeme, die fortgeschritten genug sind, einen großen Teil derselben Probleme zu lösen, dennoch radikal unterschiedliche Fehlersignaturen aufweisen.
ChatGPT war extrem homogen und fast perfekt demonstrativ.
Gemini fand alle großen Antworten, ließ aber mehr Risse in den Beweisen, besonders beim präzisen Reasoning über ein nebenläufiges System.
DeepSeek holte fast alle Hauptschlüsse, bevor es eine unverzichtbare Information in einer Abstraktion strich.
Kimi zeigte beeindruckende Software-Architektur-Kompetenz mitten in grundlegenderen Logikfehlern, teils mit außerordentlich falsch platzierter Konfidenz.
Grok war sehr stark in kausaler Inferenz, brach aber bei zeitlichen Constraints und manchen kombinatorischen Beweisen zusammen.
Das erinnert an eine Evidenz, die man hinter Leaderboards vergisst: Ein Modell hat nicht ein einzelnes Intelligenz-Level, das sich sauber in einer Zahl zusammenfassen ließe.
Selbst etabliertere Evaluationsrahmen wie HELM trennen Fähigkeiten in Szenarien und Dimensionen, statt vorzugeben, ein einzelner Score erzähle die ganze Geschichte.
GAUNTLET entzieht sich dieser Regel nicht.
Sein Ranking ist amüsant.
Seine Fehler sind weit lehrreicher.
Und nachdem ich die fünf Arbeiten gelesen habe, ist das, was mich für eine Version 2 am meisten interessiert, nicht einmal mehr, die Fragen einfach „schwerer“ zu machen.
Ich will Situationen bauen, in denen eine erste plausible Intuition genau zum falschen Ergebnis führt, wo eine lokal korrekte Lösung mehrere Abschnitte überleben muss, wo das Modell absichtlich eine zweite Chance erhält, seinen Widerspruch zu entdecken, und wo Selbstsicherheit zum falschen Zeitpunkt teuer zu stehen kommt.
Denn eine KI, die eine Antwort nicht kennt, ist ein relativ simples Problem.
Eine KI, die eine falsche Antwort findet, darum eine elegante Demonstration baut, sie verifiziert, auf den Beweis stößt, dass sie sich geirrt hat … und dann 94 % Konfidenz verkündet?
Das ist weit interessanter.
P.S. - Auch Claude und Mistral sollten am Benchmark teilnehmen. In beiden Fällen endete die Prüfung mit einem Serverfehler, bevor ich eine vollständige Antwort erhalten konnte. Gemini machte mir dasselbe zweimal; erst beim dritten Versuch gab es seine Arbeit ab. Ich ziehe es daher vor, hier nur über die Modelle zu sprechen, für die ich tatsächlich eine vollständige Antwort erhalten habe, statt denen, die nie die Ziellinie überquert haben, einen Score anzudichten.