Elon Musk sagt, dass Grok 5 eine AGI sein wird. Nur muss man das erst einmal beweisen können
Elon Musk verortet die allgemeine künstliche Intelligenz nun bei Grok 5, obwohl Grok 4.7 noch nicht einmal erschienen ist. Das Problem ist nicht nur, ob er recht hat: Niemand einigt sich bislang auf den Test, der es belegen könnte.
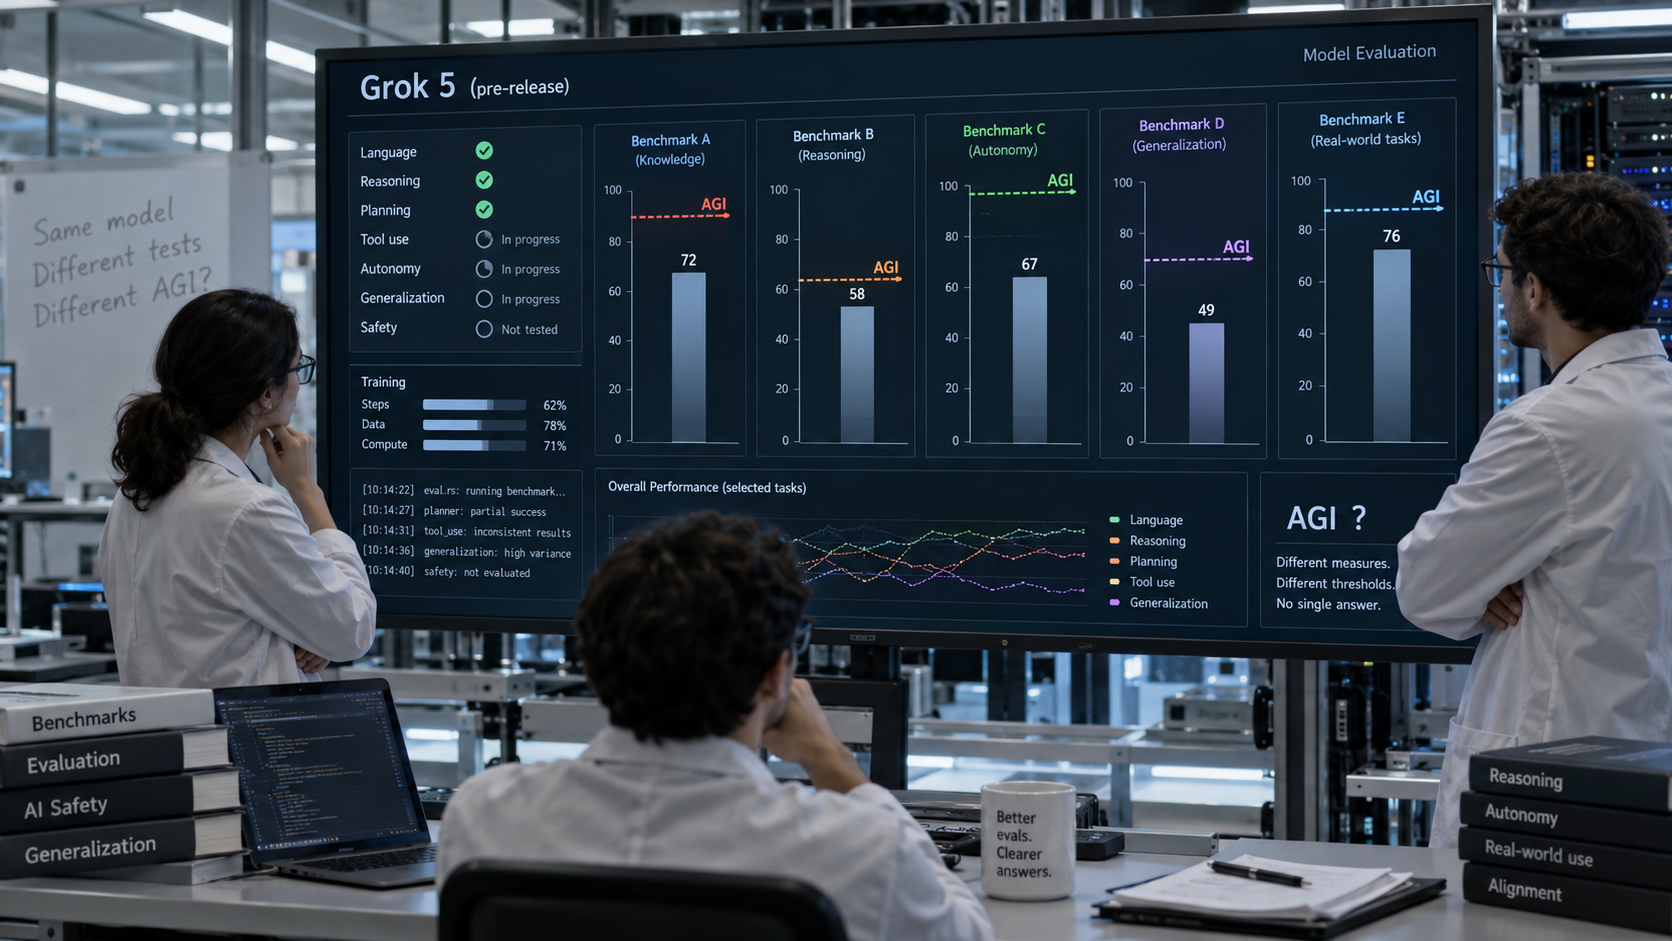
Am 14. September 2026 fragt jemand Elon Musk, wie nah Grok 4.8 an die allgemeine künstliche Intelligenz heranreicht.
Seine Antwort besteht aus fünf Worten:
« That will be Grok 5. »
Wenige Minuten später breitet Musk eine merkwürdige Skala aus: Grok 4.7 läge ungefähr auf dem Niveau von Opus 5.0, Grok 4.8 brächte eine spürbare Verbesserung, Grok 4.9 erreiche seiner Ansicht nach die Klasse von Astra oder Fable und Grok 5 könnte « besser als alles » sein.
Das Problem ist nicht, dass diese Vorhersage zwangsläufig falsch ist.
Das Problem ist weitaus fundamentaler:
Was würde es erlauben festzustellen, dass sie wahr ist?
Beginnen wir mit dem, was tatsächlich existiert
Stand 15. September 2026 ist das offiziell von SpaceXAI veröffentlichte Flaggschiff-Modell weiterhin Grok 4.6, erschienen am 12. August.
SpaceXAI beschreibt es als auf langfristige Agenten, Code und komplexe intellektuelle Arbeit ausgerichtetes Modell. Das Unternehmen behauptet unter anderem, es erreiche GPT-5.6 Sol im Artificial Analysis Intelligence Index.
Die offizielle News-Seite des Unternehmens enthält derzeit keine Ankündigung für Veröffentlichungen von Grok 4.7, 4.8, 4.9 oder 5.
Man muss also sofort zwei Kategorien trennen:
Grok 4.6 ist ein testbares Produkt.
Grok 4.7 bis 5 stellen heute eine hauptsächlich von Elon Musk angekündigte Roadmap dar.
Sie zu verwechseln würde Vorhersagen in Ergebnisse verwandeln.
Die Roadmap ist außerordentlich aggressiv geworden
Laut Musk soll Grok 4.8 ein Modell mit 2,5 Billionen Parametern sein, trainiert mit einem neuen C++-Software-Stack, dessen Haupttrainingsphase diese Woche vor dem Reinforcement Learning abgeschlossen werden soll.
Dann kämen Grok 4.9 und Grok 5.
Dieses Tempo ist schnell genug, um einen trügerischen psychologischen Effekt zu erzeugen: Jede Versionsnummer vermittelt den Eindruck, ein messbarer Schritt in Richtung eines bekannten Ziels zu sein.
4.7.
4.8.
4.9.
AGI.
Aber AGI ist keine Software-Version.
Und keine Parameterzahl stellt ihre Definition dar.
Ein Modell mit 2,5 Billionen Parametern kann immer noch nichts beweisen
Die Größe eines Modells ist interessant, um seine Architektur und seine Kosten zu verstehen.
Sie gibt nicht direkt seinen Intelligenzgrad an.
Ein größeres Modell kann untertrainiert sein. Ein kleineres Modell kann über bessere Daten, besseres Post-Training, bessere Tools oder eine effizientere Architektur verfügen.
SpaceXAIs eigene Präsentation von Grok 4.6 führt dessen Fortschritte auf längeres zusätzliches Training, ausgewählte synthetische Daten, qualitativ hochwertigere Engineering-Daten und ein verbessertes Optimierungsrezept zurück – nicht einfach auf eine Parameterzahl.
Selbst wenn Grok 4.8 tatsächlich 2,5 Billionen Parameter besitzt, sagt diese Information im Wesentlichen:
« xAI trainiert ein sehr großes Modell ».
Nicht:
« xAI nähert sich zwangsläufig der AGI ».
Das Problem beginnt mit dem Wort « AGI »
OpenAI verwendet historisch eine eher ökonomische Definition:
hochautonome Systeme, die Menschen in den meisten wirtschaftlich wertvollen Arbeiten übertreffen.
Google DeepMind schlug einen anderen Ansatz vor, der insbesondere die Tiefe der Leistung und die Breite bzw. Allgemeinheit der Fähigkeiten trennt, mit mehreren möglichen Stufen statt eines binären Schalters « AGI / keine AGI ».
Andere Forscher bevorzugen weiterhin:
-
die Fähigkeit zum allgemeinen Lernen;
-
den Transfer zu neuen Aufgaben;
-
abstraktes Denken;
-
Autonomie;
-
Anpassung an unbekannte Umgebungen;
-
oder eine Kombination dieser Eigenschaften.
Das schafft eine ziemlich absurde Situation.
Zwei Labore können exakt dasselbe System bauen und vernünftigerweise zu dem Schluss kommen:
« Wir haben AGI erreicht. »
und:
« Wir haben AGI nicht erreicht. »
einfach weil sie nicht vom selben sprechen.
Die aktuellen Benchmarks verschärfen das Problem
Ein Benchmark ist nützlich, wenn die Fähigkeit, die er misst, präzise definiert ist.
Ein Modell kann 90 % bei einem Programmiertest erreichen.
Sehr gut.
Es kann einen durchschnittlichen Arzt bei bestimmten Fragen übertreffen.
Sehr gut.
Es kann ehemals schwierige mathematische Probleme lösen.
Auch sehr gut.
Aber die Summe ausreichend beeindruckender Benchmarks erzeugt nicht automatisch eine Eigenschaft namens « allgemeine Intelligenz ».
Die aktuellen Benchmarks leiden zudem unter mehreren bekannten Problemen: potenzielle Kontamination der Trainingsdaten, direkte oder indirekte Optimierung auf die Tests, Sättigung, Abhängigkeit vom verwendeten Harness und die Kluft zwischen dem Bestehen einer kurzen Übung und der zuverlässigen Ausführung echter Arbeit über mehrere Stunden oder Tage.
Ein System kann drei Minuten lang übermenschlich sein und drei Stunden lang überraschend fragil.
Dieser Kontrast ist für AGI wahrscheinlich weitaus wichtiger als ein zusätzlicher Zehntelpunkt auf einer Bestenliste.
Dann bauen wir einen Test, den Grok 5 tatsächlich nicht bestehen könnte
Eine interessante wissenschaftliche Behauptung muss widerlegbar sein.
Wenn Grok 5 als AGI angekündigt wird, möchte ich mindestens, dass fünf Eigenschaften öffentlich getestet werden.
1. Eine echte Breite an Fähigkeiten
Keine zwanzig Varianten verbalen Denkens.
Ein und dasselbe System sollte auf hohem menschlichen Niveau in tatsächlich verschiedenen Domänen performen: Programmierung, wissenschaftliche Analyse, Dokumentenrecherche, Planung, Kommunikation, Softwarebedienung, quantitatives Denken und berufliche Aufgaben.
Allgemeinheit muss horizontal gemessen werden, nicht nur vertikal.
2. Der Transfer zu Problemen, die es nie gelernt hat zu erkennen
Der interessanteste Test ist nicht:
« Kennt es dieses Problem? »
sondern:
« Kann es eine genuin neue Problemklasse mit wenigen Beispielen verstehen? »
Das ist eine essenzielle Eigenschaft menschlicher Intelligenz.
Eine seriöse AGI-Evaluation sollte daher einen wesentlichen Teil ihrer Umgebungen bis nach dem Training zurückhalten und Übungen vermeiden, die im Internet bereits berühmt geworden sind.
3. Langzeitautonomie
Ein allgemeines System sollte nicht benötigen, dass ein Mensch jede Arbeit in fünfzehn Prompts zerlegt.
Geben wir ihm ein Ziel von mehreren Stunden oder Tagen.
Es muss recherchieren, planen, Software nutzen, eigene Fehler erkennen, die Strategie wechseln, seinen Kontext bewahren und schließlich ein überprüfbares Ergebnis liefern.
Das wichtige Kriterium ist nicht, dass es eine außergewöhnliche Demo besteht.
Es ist die Häufigkeit, mit der es korrekt abschließt.
4. Die Fähigkeit zu wissen, dass man nicht weiß
Eine extrem kompetente Intelligenz, die unfähig ist, ihre eigenen Unsicherheiten zu identifizieren, bleibt gefährlich fragil.
Man muss also nicht nur korrekte Antworten messen, sondern auch die Kalierung:
wenn Grok 5 angibt, zu 90 % recht zu haben, ist es dann tatsächlich in etwa neun von zehn Fällen korrekt?
Kann es erkennen, dass ihm eine Information fehlt?
Kann es die richtigen Daten zum richtigen Zeitpunkt anfordern?
Intelligenz ist nicht nur, eine Antwort zu produzieren.
Es ist auch, zu bestimmen, wann noch keine verlässliche Antwort möglich ist.
5. Echte Leistung, ohne nur seine Lieblingsterrains zu wählen
Schließlich sollte die Evaluation an Aufgaben durchgeführt werden, die von mehreren unabhängigen Organisationen definiert und spät offengelegt werden.
Andernfalls hat der Modellbauer einen offensichtlichen Vorteil: Er kann die Benchmarks auswählen, auf denen sein System am beeindruckendsten wirkt.
Eine hinreichend allgemeine AGI sollte nicht von einer besonders vorteilhaften redaktionellen Auswahl an Tests abhängen.
Und selbst dieses Raster würde nicht alles regeln
Sie würde immer noch keine universelle philosophische Definition von Intelligenz schaffen.
Das ist nicht notwendig.
Sie würde etwas Nützlicheres tun:
« Grok 5 wird AGI sein » in eine widerlegbare Behauptung verwandeln.
Stellen Sie sich vor:
-
Allgemeinheit: bestanden;
-
Transfer: bestanden;
-
Langzeitautonomie: unzureichend;
-
Kalibrierung: unzureichend;
-
Echte Arbeit: nahe am menschlichen Niveau.
Wir könnten dann eine präzise Diskussion darüber führen, was fehlt.
Das ist unendlich informativer als drei Wochen lang zu debattieren, ob das Wort AGI « angemessen scheint ».
AGI und Superintelligenz sind keine Synonyme
Eine weitere Verwechslung wird unweigerlich kommen.
Wenn ein System eine dem Menschen vergleichbare oder überlegene allgemeine Intelligenz in einer großen Vielfalt von Aufgaben erreicht, bedeutet das nicht notwendigerweise, dass es über eine Superintelligenz verfügt, die die besten Menschen in allen Bereichen übertrifft.
Ein menschlicher Allgemeinarzt besitzt allgemeine Intelligenz.
Er ist nicht besser als jeder Chirurg, Mathematiker, Programmierer, Physiker und Anwalt auf dem Planeten.
Eine künftige AGI könnte ähnlich funktionieren: außerordentlich vielseitig, ohne allwissend zu sein.
Diese Unterscheidung wird essenziell, wenn Musk hinzufügt, Grok 5 könnte « better than anything » sein.
Bestes verfügbares Modell und AGI sind zwei völlig unterschiedliche Behauptungen.
Musk selbst hatte noch vor weniger als einem Jahr weit mehr Zweifel
Im Oktober 2025 schätzte Elon Musk öffentlich die Wahrscheinlichkeit, dass Grok 5 AGI erreicht, auf etwa 10 %.
Im September 2026 wurde seine Formulierung weitaus kategorischer: Auf die Frage, ob Grok 4.8 sich dem annähern werde, verwies er direkt auf Grok 5.
Vielleicht hat xAI außergewöhnliche interne Ergebnisse erzielt.
Das ist möglich.
Aber die Öffentlichkeit verfügt nicht darüber.
Und solange sie nicht verfügbar sind, ist die rationale Position weder:
« Musk lügt ».
noch:
« Grok 5 wird AGI sein ».
Sondern:
wir haben eine Vorhersage des Chefs des Unternehmens, das das Modell baut.
Sie wird interessant, wenn sie mit Daten konfrontiert wird.
Die erste AGI sollte nicht davon abhängen, wer das Wort als Erster ausspricht
Der aktuelle Wettlauf schafft einen offensichtlichen Anreiz.
Das erste Unternehmen zu sein, das sagen kann:
« Wir haben AGI geschaffen »
wäre vermutlich eine der mächtigsten Technologie-Ankündigungen der modernen Geschichte.
Genau dieser Prestige macht die Existenz definierter Kriterien vor dem Ergebnis unverzichtbar.
Andernfalls kann der Begriff so lange verschoben werden, bis er zum gerade gebauten Produkt passt.
Das ist das Äquivalent dazu, ein Rennen ohne Ziellinie zu veranstalten und dann jeden Konkurrenten seine eigene unter den Füßen ziehen zu lassen.
Grok 5 könnte außergewöhnlich werden.
Es könnte sogar das System werden, das uns kollektiv zwingt anzuerkennen, dass sich etwas geändert hat.
Aber wenn das tatsächlich eintritt, sollten wir nicht einen Tweet von Elon Musk brauchen, um uns davon zu überzeugen.
Eine echte AGI sollte an ihren Fähigkeiten erkennbar sein, bevor sie es an ihrem Marketing ist.