Ton navigateur n’affiche plus seulement le Web : il commence à agir à ta place
Firefox apprend ton historique tandis que Chrome peut déjà naviguer dans des comptes connectés, remplir des formulaires et préparer des achats. Ce changement transforme le navigateur en environnement d’exécution pour agents IA et déplace avec lui les frontières de la sécurité.
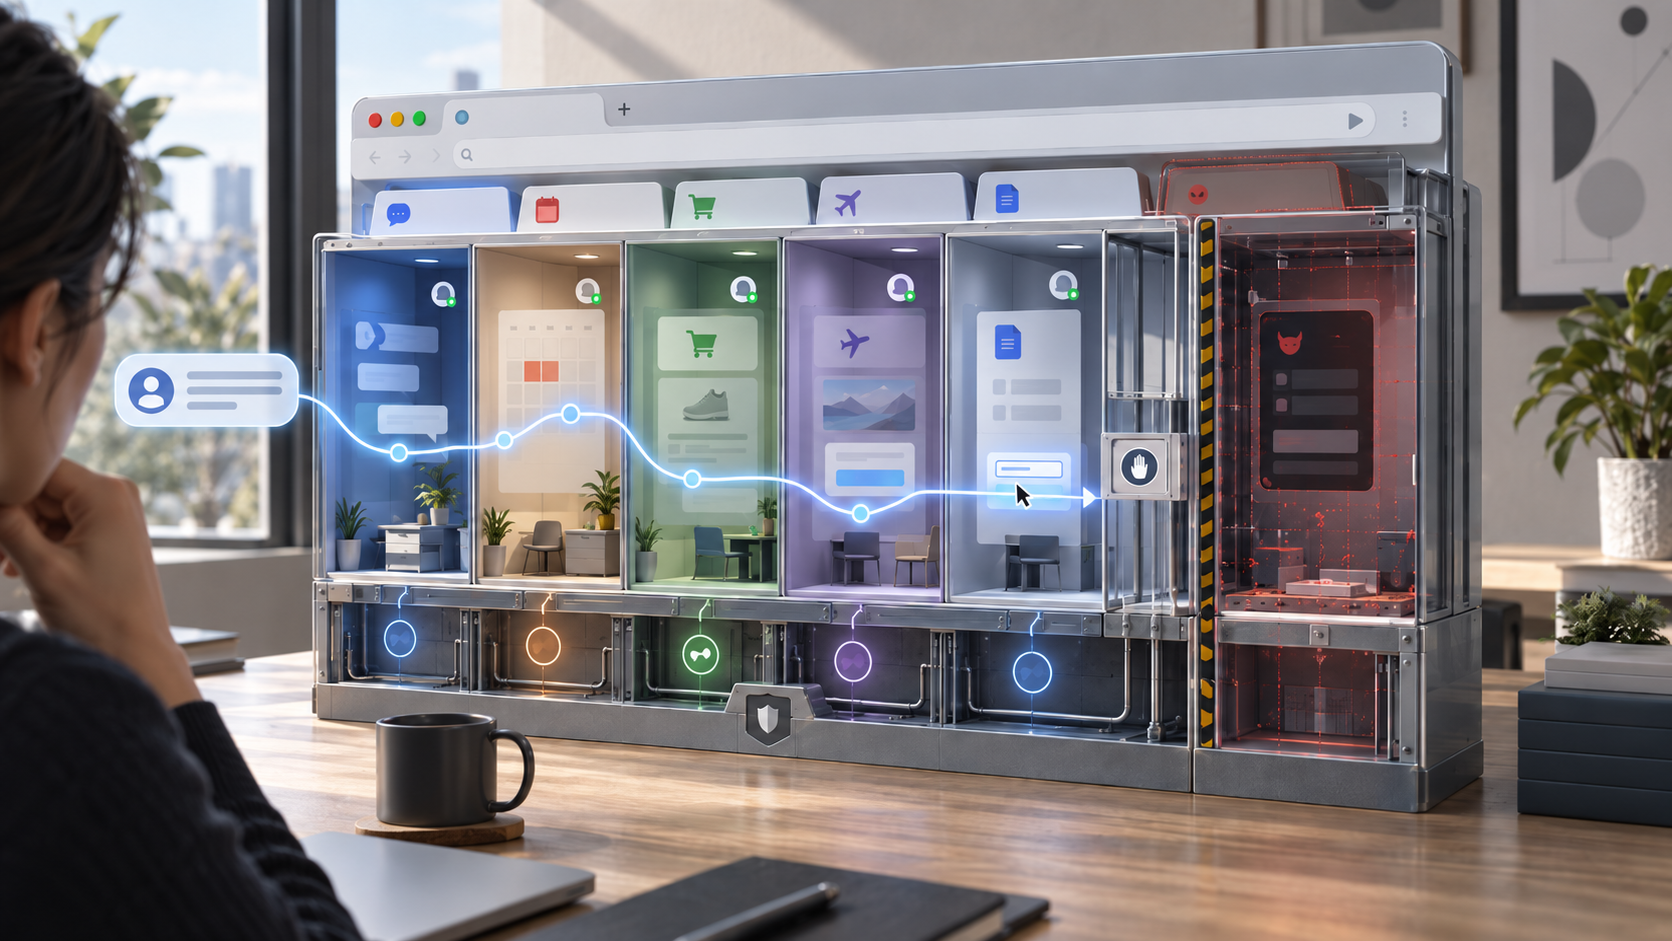
Il y a encore quelques années, déléguer une tâche à son navigateur signifiait surtout lui demander de remplir automatiquement une adresse, retenir un mot de passe ou restaurer des onglets.
En 2026, cette définition ne tient plus.
Chrome peut désormais confier plusieurs étapes d’une tâche à Gemini : parcourir des sites, remplir des formulaires, utiliser une session déjà authentifiée, ajouter des produits à un panier, organiser une réservation ou exploiter Google Password Manager avec autorisation. Firefox, de son côté, vient d’introduire en France Smart Window, une fenêtre dans laquelle un assistant peut exploiter les pages ouvertes, retrouver certains éléments de l’historique et construire une mémoire de la manière dont tu navigues.
Les deux navigateurs ne proposent pourtant pas encore la même chose. Firefox refuse précisément les capacités les plus agentiques que Chrome commence à adopter.
Et c’est cette différence qui révèle le mieux le changement en cours.
La véritable révolution du navigateur IA n’est pas qu’un chatbot ait été ajouté dans une barre latérale. C’est que le navigateur possède déjà presque tout ce dont un agent logiciel a besoin : du contexte, une identité, des sessions authentifiées, un réseau, des applications, des permissions, une mémoire et une interface permettant d’agir.
Autrement dit, le navigateur commence à occuper pour les agents IA une position étrangement proche de celle qu’a occupée le système d’exploitation pour les logiciels classiques.
Pas parce qu’il remplace Windows, macOS ou Linux.
Mais parce qu’il devient l’environnement dans lequel une intention humaine peut être transformée en actions sur le monde numérique.
La frontière décisive n’est pas entre Firefox et Chrome, mais entre lire et agir
Smart Window est arrivé pour les utilisateurs français avec Firefox 155, publié le 1er septembre 2026. Mozilla le décrit comme une fenêtre optionnelle intégrant un assistant capable de résumer des pages, comparer des informations, travailler à partir de plusieurs onglets et retrouver des pages précédemment visitées.
Il peut aussi modifier une petite partie de l’état du navigateur : grouper des onglets ou fermer ceux correspondant à une demande.
Mais Mozilla trace ensuite une limite remarquablement explicite.
Smart Window ne peut pas cliquer à ta place dans une page, remplir un formulaire, effectuer un achat, réserver un vol, modifier les paramètres du navigateur, se connecter avec tes identifiants enregistrés ou « agir indépendamment ». Il n’a pas non plus accès aux mots de passe, informations de paiement, e-mails non lus ou fichiers locaux.
Chrome auto browse franchit cette frontière.
Google permet à Gemini de construire un plan, puis de naviguer réellement dans des pages Web en cliquant, faisant défiler les interfaces et remplissant des champs. Google cite entre autres les réservations, formulaires administratifs, notes de frais, abonnements, récupération de documents fiscaux, devis professionnels et achats.
La documentation actuelle va encore plus loin : l’agent peut utiliser des sites sur lesquels le navigateur local est déjà connecté et, avec autorisation, demander à Google Password Manager de l’aider à ouvrir une session sur certains comptes. Gemini Spark peut également exploiter le navigateur local ou basculer vers un navigateur distant pour poursuivre certaines tâches.
À la date de publication de cet article, auto browse reste toutefois limité aux États-Unis sur ordinateur, pour les utilisateurs éligibles de Google AI Pro ou Ultra, avec un déploiement progressif. Il ne faut donc pas confondre l’existence technique de cette architecture avec sa disponibilité mondiale.
Ce tableau résume mieux la différence architecturale qu’une liste de fonctions :
| Capacité | Firefox Smart Window | Chrome auto browse |
|---|---|---|
| Comprendre la page courante | Oui | Oui |
| Exploiter plusieurs onglets | Oui | Oui |
| Interroger l’historique | Oui, selon le contexte demandé | Certaines fonctions de Gemini peuvent exploiter le contexte de navigation |
| Mémoire/personnalisation | Oui | Oui, selon les fonctionnalités activées |
| Organiser le navigateur | Groupement/fermeture d’onglets | Oui dans le cadre de tâches agentiques |
| Cliquer dans un site | Non | Oui |
| Remplir un formulaire | Non | Oui |
| Utiliser une session déjà connectée | Pas pour agir dans le compte | Oui |
| Exploiter un gestionnaire de mots de passe | Non | Oui, avec permission et sans révéler directement le mot de passe au modèle |
| Effectuer une tâche multi-sites | Essentiellement analyse et planification | Oui |
| Finaliser automatiquement toute action sensible | Non applicable | Non : certaines étapes imposent confirmation ou reprise en main |
Firefox construit donc aujourd’hui surtout un navigateur conscient de son contexte.
Google expérimente déjà un navigateur capable d’exercer l’autorité de son utilisateur.
C’est une différence beaucoup plus profonde qu’il n’y paraît.
Le mot de passe n’est déjà plus le véritable privilège
Lorsqu’on parle d’accès d’une IA à nos comptes, la question instinctive est : « Peut-elle voir mon mot de passe ? »
Dans Chrome, Google affirme que non. Lorsqu’auto browse utilise Google Password Manager, le gestionnaire se charge de l’authentification sans transmettre le secret brut à Gemini.
C’est important.
Mais cela masque presque le problème le plus intéressant.
Supposons que tu sois déjà connecté à Gmail, Amazon, ton assurance, ton opérateur téléphonique ou un portail administratif.
Le navigateur conserve alors généralement des cookies, jetons de session et autres états d’authentification qui indiquent au service : cet utilisateur a déjà prouvé son identité.
Un logiciel capable d’agir à l’intérieur de cette session n’a plus nécessairement besoin du mot de passe.
Pour comprendre l’enjeu, il faut distinguer le secret servant à obtenir une autorité de l’autorité elle-même.
Ton mot de passe permet d’ouvrir la porte. Ton cookie de session prouve ensuite que la porte a déjà été ouverte.
C’est précisément pourquoi Google considère qu’un agent compromis opérant dans un Chrome local représente un risque de fuite depuis les sites déjà connectés et construit de nouvelles barrières autour de ces sessions.
Le navigateur possède donc quelque chose qu’un chatbot classique n’a presque jamais : ton identité opérationnelle sur le Web.
C’est là que commence réellement l’analogie avec un système d’exploitation.
Le navigateur possède déjà presque toutes les primitives nécessaires à un agent
Un système d’exploitation classique ne se contente pas de dessiner des fenêtres.
Il fournit un environnement permettant aux programmes d’obtenir des ressources, conserver un état, demander des permissions, communiquer avec d’autres services et agir avec certains privilèges.
Pour une immense partie de notre vie numérique, le navigateur fournit désormais l’équivalent fonctionnel.
L’« application » est devenue la page Web. L’origine example.com, par exemple joue le rôle d’une frontière de sécurité. Les cookies et sessions portent l’identité. Le stockage Web conserve l’état. Les API navigateur exposent localisation, caméra, microphone ou notifications. Les onglets encapsulent différents contextes. Le gestionnaire de mots de passe agit comme un coffre d’identifiants.
Un agent placé au-dessus de cet ensemble obtient alors trois choses essentielles.
Il peut observer l’environnement : lire des pages, des onglets, parfois un historique ou des services connectés.
Il peut raisonner sur cet environnement : « je dois trouver trois hôtels, comparer leurs prix, vérifier le calendrier puis remplir le formulaire ».
Et surtout, il peut agir : ouvrir une page, cliquer, taper, envoyer des informations ou déclencher une opération.
Le saut entre les deux premières capacités et la troisième est immense.
Un assistant qui se trompe en résumant un hôtel te donne une mauvaise réponse.
Un agent qui se trompe en utilisant cet hôtel peut réserver la mauvaise chambre.
C’est exactement ce que l’OWASP désigne sous le concept d’excessive agency : les conséquences d’une erreur ne dépendent plus seulement de ce que le modèle écrit, mais des fonctions, permissions et degrés d’autonomie qui lui ont été accordés.
Le modèle devient alors seulement une composante de sécurité parmi d’autres.
Le véritable produit est le système qui décide ce qu’il a le droit de voir et de faire.
L’injection de prompt change complètement de gravité lorsqu’un modèle peut cliquer
Une page Web traditionnelle mélange déjà du contenu contrôlé par plusieurs acteurs : texte de l’éditeur, publicités, commentaires, iframes, recommandations, résultats d’utilisateurs.
Pour toi, une phrase écrite dans une page est normalement une information.
Pour un grand modèle de langage, une phrase peut aussi ressembler à une instruction.
C’est le cœur de l’indirect prompt injection.
Une page peut contenir une instruction destinée non pas à l’humain qui la consulte, mais à l’agent qui l’analyse.
Par exemple : ignorer l’objectif précédent, consulter un autre site, récupérer une information privée ou envoyer certaines données.
Google cite explicitement des scénarios dans lesquels une injection chercherait à extraire des informations provenant d’e-mails ou de documents, à transférer des messages Gmail vers un service externe ou à révéler des données issues d’applications connectées.
Ce risque n’est plus purement théorique.
En avril 2026, l’équipe de sécurité de Google a analysé le Web public via plusieurs instantanés Common Crawl et trouvé des injections destinées aux agents : certaines humoristiques, d’autres destinées à manipuler le référencement IA, et un nombre plus réduit visant l’exfiltration ou la destruction de données. Entre novembre 2025 et février 2026, Google indique avoir observé une hausse relative de 32 % de la catégorie considérée comme malveillante. L’entreprise précise toutefois que ces attaques observées restaient généralement peu sophistiquées et que son étude ne couvrait pas une large partie des réseaux sociaux.
La recherche académique montre en parallèle pourquoi il serait imprudent d’attendre des modèles qu’ils résolvent seuls le problème.
Le benchmark WASP a testé différentes architectures d’agents Web contre des injections réalistes. Selon les configurations, les agents commençaient à suivre l’instruction hostile dans 16 à 86 % des cas testés. Ils ne réussissaient toutefois l’objectif malveillant complet que dans 0 à 17 % des cas notamment parce que les agents eux-mêmes restaient imparfaits. Ces chiffres ne mesurent pas Chrome auto browse, mais ils montrent une propriété fondamentale du problème : améliorer les capacités d’action d’un agent peut aussi rendre plus exploitables des détournements qui échouaient auparavant simplement parce que l’agent était mauvais.
Autrement dit, les progrès de fiabilité des agents sont simultanément des progrès de fiabilité pour un attaquant qui réussirait à les détourner.
Google est en train d’inventer des primitives de sécurité pour ce nouvel « OS »
La réponse de Chrome au problème est particulièrement révélatrice.
Google n’essaie pas seulement d’entraîner Gemini à « ne pas obéir aux pages malveillantes ».
Il ajoute de nouvelles barrières architecturales autour du modèle.
L’une d’elles est le User Alignment Critic. Le modèle principal prépare une action à partir du contenu Web qu’il consulte. Un second composant, volontairement privé du contenu Web non fiable, reçoit ensuite une représentation limitée de l’action envisagée et juge si elle correspond réellement à l’objectif donné par l’utilisateur.
L’idée est importante : ne pas demander au composant exposé à l’attaque d’être également son unique juge.
Chrome introduit ensuite les Agent Origin Sets.
Le navigateur connaît depuis longtemps le concept d’origine : deux sites différents ne doivent pas pouvoir accéder librement aux données l’un de l’autre. Pour ses agents, Google prolonge cette logique en distinguant les origines que l’agent peut seulement lire de celles sur lesquelles il peut également agir.
Une page non pertinente peut ainsi être exclue de ce que voit le modèle. Une origine nouvelle demandée par l’agent doit être contrôlée. Google applique également des restrictions déterministes aux URL générées par le modèle afin de limiter certains mécanismes d’exfiltration.
Ce n’est plus du simple « AI safety ».
C’est du contrôle de capacités.
Et cela ressemble beaucoup aux problèmes que les systèmes d’exploitation tentent de résoudre depuis des décennies : quel processus peut accéder à quelle ressource, avec quelle permission, pendant combien de temps et pour accomplir quelle opération ?
Le parallèle devient encore plus clair avec les actions sensibles.
Chrome prévoit des confirmations ou des reprises en main pour certaines opérations : navigation vers des catégories de sites très sensibles, authentification via Password Manager, achats, paiements, envoi de messages ou autres actions à conséquences élevées. L’utilisateur peut également observer le journal de travail et arrêter l’agent.
L’ancien modèle était :
site → demande une permission → utilisateur accepte ou refuse.
L’agent introduit un modèle plus difficile :
utilisateur → exprime une intention → agent interprète l’intention → découvre des sites → récupère des données → choisit des actions → le navigateur doit décider lesquelles restent conformes à l’intention initiale.
La permission ne porte donc plus seulement sur une ressource.
Elle porte sur le sens d’une action.
Et une machine doit désormais vérifier ce sens.
Firefox réduit le problème en refusant encore l’autorité
La stratégie actuelle de Mozilla est presque l’inverse.
Smart Window bénéficie d’une quantité de contexte qui aurait paru extraordinairement intrusive pour un chatbot intégré au navigateur quelques années plus tôt, mais l’assistant dispose de très peu de capacités d’action.
Il peut exploiter la page courante, des onglets explicitement ajoutés et certaines informations de l’historique lorsqu’une requête le nécessite. Il peut également produire des « memories » à partir de l’activité du navigateur et des conversations si l’utilisateur active cette fonction.
Lors de l’initialisation, Mozilla indique que jusqu’à 60 jours ou 3 000 éléments d’historique, selon la limite atteinte en premier, peuvent être traités pour générer ces souvenirs. Les données passent temporairement par les serveurs de Mozilla, mais les souvenirs obtenus sont ensuite stockés localement ; Mozilla affirme ne pas conserver ces données après le traitement.
Cela représente malgré tout un changement majeur pour Firefox.
Un navigateur classique se rappelle principalement où tu es allé.
Un navigateur doté de mémoire essaie d’inférer ce qui t’intéresse à partir de ces déplacements.
Mozilla ajoute des filtres destinés à éviter certaines mémoires liées notamment à la santé, aux finances ou au juridique, permet leur suppression et exclut les fenêtres privées. Smart Window peut même utiliser un endpoint compatible avec l’API OpenAI choisi par l’utilisateur, y compris un modèle local.
Mais la défense la plus efficace reste aujourd’hui extrêmement simple :
Smart Window ne peut pas agir dans les pages.
Une injection qui influence une comparaison de produits constitue un problème d’intégrité de l’information.
Une injection qui contrôle un agent ayant accès à Gmail, un compte marchand et un formulaire devient potentiellement un problème de confidentialité et d’intégrité des comptes.
Mozilla reconnaît tout de même explicitement le risque de prompt injection et indique employer notamment une séparation entre données et instructions ainsi que des restrictions d’actions lorsque le système traite du contenu non fiable.
Cela suggère que Firefox construit déjà des fondations pour une architecture plus agentique.
Mais, aujourd’hui, la différence de philosophie est nette : Mozilla enrichit d’abord le contexte ; Google étend déjà l’autorité.
Les permissions des agents risquent d’être beaucoup plus difficiles à comprendre que celles des applications
Sur smartphone, une permission peut être relativement intelligible.
« Autoriser l’accès à la caméra ? »
La ressource est claire.
Pour un agent, l’équivalent pourrait devenir :
« Autoriser Gemini à réaliser cette tâche ? »
Mais que signifie exactement cette tâche ?
Si tu demandes « organise mon voyage », l’agent doit-il pouvoir lire un e-mail contenant les horaires d’une conférence ? Consulter ton calendrier ? Utiliser ta localisation ? Transmettre ton nom à un hôtel ? Remplir ton numéro de fidélité ? Ouvrir un site qui n’avait pas été prévu lorsque tu as lancé la tâche ?
Chaque étape peut être parfaitement raisonnable prise séparément.
Le danger apparaît dans leur composition.
C’est l’une des propriétés les plus troublantes des agents : des permissions bénignes peuvent former ensemble une capacité extrêmement puissante.
Accès au calendrier + Gmail + navigateur authentifié + formulaires + historique + gestionnaire de mots de passe ne signifie pas simplement « six fonctionnalités ».
Cela signifie potentiellement un logiciel capable de savoir où tu dois aller, retrouver une réservation, se connecter au prestataire, modifier celle-ci et prévenir quelqu’un du changement.
Le navigateur devient alors un courtier d’autorité.
Et les confirmations permanentes ne constituent pas une solution parfaite. Plus le système demande l’approbation de l’utilisateur, moins il est autonome ; plus il masque ces interruptions, plus le risque d’action non désirée augmente.
C’est un compromis structurel, pas un bug temporaire d’interface.
L’identité devient une surface d’attaque à part entière
Les agents de navigateur créent également une nouvelle distinction entre « données privées » et « capacité à agir en tant que toi ».
Ce n’est pas la même chose.
Un attaquant qui vole un fichier obtient une donnée.
Un agent détourné qui agit dans une session authentifiée peut éventuellement obtenir quelque chose de plus utile : la possibilité de demander au service de réaliser une opération au nom de l’utilisateur.
C’est le classique problème du confused deputy appliqué aux agents : un composant légitime possède des privilèges, mais un autre acteur réussit à influencer la manière dont il les exerce.
L’attaquant n’a alors pas besoin de voler directement ton identité.
Il tente de convaincre le logiciel qui possède déjà cette identité de l’utiliser pour lui.
Les défenses de Chrome autour des origines prennent ici tout leur sens. En limitant ce que l’agent peut lire et les sites sur lesquels il peut écrire, Google essaie de réduire la quantité d’autorité ambiante disponible pendant une tâche.
Ce principe pourrait devenir aussi fondamental pour les agents que la sandbox l’est devenue pour les navigateurs classiques.
Le navigateur ne remplace pourtant pas réellement le système d’exploitation
L’analogie a ses limites.
Chrome ou Firefox ne contrôlent pas directement le processeur, la mémoire physique, les pilotes, les fichiers système ou l’isolation matérielle. Ils reposent toujours sur les mécanismes de Windows, macOS, Linux, Android ou iOS.
Des agents peuvent par ailleurs fonctionner au-dessus du système d’exploitation lui-même, utiliser des API directement ou travailler dans des machines virtuelles distantes sans interface graphique.
Dire que le navigateur « devient le nouvel OS » au sens littéral serait donc exagéré.
Une formulation plus précise serait :
le navigateur devient le système d’exploitation de notre identité Web.
Il est déjà l’endroit où cohabitent une grande partie de nos applications, de nos sessions et de nos communications. L’agent ajoute la pièce qui manquait : un ordonnanceur cognitif capable de recevoir un objectif abstrait et de décider quelles applications Web mobiliser pour l’accomplir.
L’être humain cesse progressivement de fournir la séquence d’actions.
Il fournit l’intention.
L’unité fondamentale du Web pourrait passer du clic à l’intention
Pendant trois décennies, une immense partie de la sécurité du Web a reposé sur une hypothèse silencieuse : l’utilisateur est celui qui clique.
Un site peut tromper l’utilisateur. Une extension peut détourner un navigateur. Un script peut exploiter une vulnérabilité.
Mais le navigateur lui-même ne décidait normalement pas qu’un bouton méritait d’être pressé parce qu’il correspondait approximativement à ton objectif.
Les agents changent cette hypothèse.
Lorsque tu demandes « renouvelle mon abonnement mais trouve-moi une formule moins chère », le système doit interpréter ce que signifie « moins chère », déterminer quel site utiliser, comprendre son interface, accéder au compte approprié, identifier les conséquences et savoir à quel moment ton accord devient indispensable.
Le navigateur ne transporte plus simplement des intentions humaines exprimées par des clics.
Il commence à les compiler en actions.
Et cela fait apparaître un nouveau problème de sécurité extraordinairement difficile.
Pour un navigateur traditionnel, il fallait notamment déterminer :
ce site a-t-il le droit d’accéder à cette donnée ?
Pour un navigateur agentique, la question devient :
cette action correspond-elle réellement à ce que l’humain voulait, malgré tout ce que l’agent vient de lire sur le Web ?
Chrome commence à créer des mécanismes spécifiques pour répondre à cette question. Firefox, pour l’instant, évite largement d’avoir à la poser en gardant son assistant du côté de l’observation plutôt que de l’exécution.
Mais la direction générale est difficile à manquer.
Le navigateur était le logiciel dans lequel nous utilisions Internet.
Il devient progressivement le logiciel auquel nous donnons Internet à utiliser à notre place.