Dein Browser zeigt nicht mehr nur das Web an: Er beginnt, an deiner Stelle zu handeln
Firefox lernt deinen Verlauf, während Chrome bereits in eingeloggten Accounts navigieren, Formulare ausfüllen und Einkäufe vorbereiten kann. Dieser Wandel verwandelt den Browser in eine Laufzeitumgebung für KI-Agenten und verschiebt damit die Grenzen der Sicherheit.
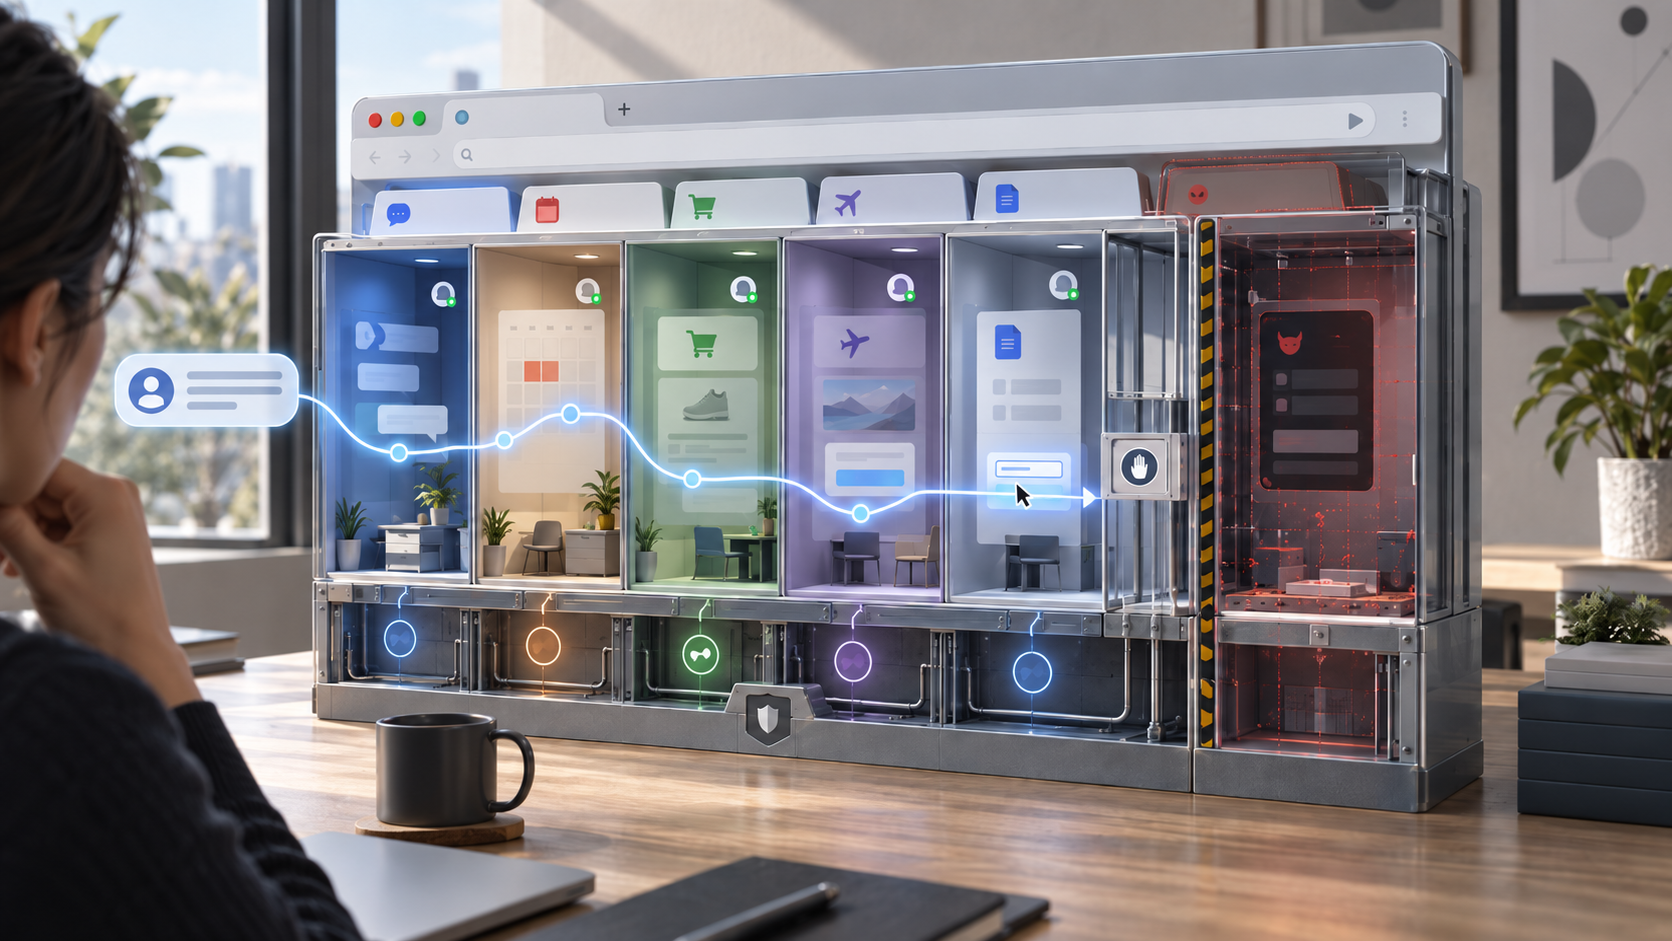
Vor noch wenigen Jahren bedeutete es, eine Aufgabe an seinen Browser zu delegieren, vor allem, ihn eine Adresse automatisch ausfüllen, ein Passwort speichern oder Tabs wiederherstellen zu lassen.
Im Jahr 2026 hält diese Definition nicht mehr stand.
Chrome kann nun mehrere Schritte einer Aufgabe an Gemini übergeben: Websites durchsuchen, Formulare ausfüllen, eine bereits authentifizierte Sitzung nutzen, Produkte in den Warenkorb legen, eine Buchung organisieren oder den Google Password Manager mit Erlaubnis einsetzen. Firefox seinerseits hat gerade in Frankreich Smart Window eingeführt, ein Fenster, in dem ein Assistent die offenen Seiten nutzen, bestimmte Elemente des Verlaufs wiederfinden und ein Gedächtnis davon aufbauen kann, wie du surfst.
Beide Browser bieten jedoch noch nicht dieselben Möglichkeiten. Firefox verweigert genau die agentischsten Fähigkeiten, die Chrome beginnt zu übernehmen.
Und es ist dieser Unterschied, der den laufenden Wandel am besten verdeutlicht.
Die wahre Revolution des KI-Browsers besteht nicht darin, dass ein Chatbot in einer Seitenleiste hinzugefügt wurde. Sondern darin, dass der Browser bereits fast alles besitzt, was ein Software-Agent braucht: Kontext, Identität, authentifizierte Sitzungen, ein Netzwerk, Anwendungen, Berechtigungen, ein Gedächtnis und eine Schnittstelle zum Handeln.
Mit anderen Worten: Der Browser beginnt, für KI-Agenten eine Position einzunehmen, die seltsam an die erinnert, die das Betriebssystem für klassische Software eingenommen hat.
Nicht weil er Windows, macOS oder Linux ersetzt.
Sondern weil er die Umgebung wird, in der eine menschliche Absicht in Aktionen auf die digitale Welt umgewandelt werden kann.
Die entscheidende Grenze verläuft nicht zwischen Firefox und Chrome, sondern zwischen Lesen und Handeln
Smart Window kam für französische Nutzer mit Firefox 155, veröffentlicht am 1. September 2026. Mozilla beschreibt es als optionales Fenster, das einen Assistenten integriert, der Seiten zusammenfassen, Informationen vergleichen, von mehreren Tabs aus arbeiten und zuvor besuchte Seiten wiederfinden kann.
Er kann auch einen kleinen Teil des Browser-Zustands verändern: Tabs gruppieren oder solche schließen, die einer Anfrage entsprechen.
Doch Mozilla zieht dann eine bemerkenswert explizite Grenze.
Smart Window kann nicht an deiner Stelle in einer Seite klicken, ein Formular ausfüllen, einen Kauf tätigen, einen Flug buchen, Browsereinstellungen ändern, sich mit deinen gespeicherten Zugangsdaten einloggen oder „unabhängig handeln“. Er hat auch keinen Zugriff auf Passwörter, Zahlungsinformationen, ungelesene E-Mails oder lokale Dateien.
Chrome auto browse überschreitet diese Grenze.
Google erlaubt es Gemini, einen Plan zu erstellen, dann tatsächlich durch Webseiten zu navigieren, indem geklickt, durch Interfaces gescrollt und Felder ausgefüllt werden. Google nennt unter anderem Buchungen, Verwaltungsformulare, Spesenabrechnungen, Abonnements, Abruf von Steuerdokumenten, professionelle Kostenvoranschläge und Einkäufe.
Die aktuelle Dokumentation geht noch weiter: Der Agent kann Websites nutzen, auf denen der lokale Browser bereits eingeloggt ist, und mit Erlaubnis den Google Password Manager bitten, beim Öffnen einer Sitzung auf bestimmten Konten zu helfen. Gemini Spark kann ebenfalls den lokalen Browser nutzen oder auf einen Remote-Browser umschalten, um bestimmte Aufgaben fortzusetzen.
Zum Veröffentlichungsdatum dieses Artikels bleibt auto browse jedoch auf die USA am Desktop beschränkt, für berechtigte Nutzer von Google AI Pro oder Ultra, mit schrittweisem Rollout. Man sollte also die technische Existenz dieser Architektur nicht mit ihrer weltweiten Verfügbarkeit verwechseln.
Diese Tabelle fasst die architektonische Unterschied besser zusammen als eine Funktionsliste:
| Fähigkeit | Firefox Smart Window | Chrome auto browse |
|---|---|---|
| Aktuelle Seite verstehen | Ja | Ja |
| Mehrere Tabs nutzen | Ja | Ja |
| Verlauf abfragen | Ja, je nach angefragtem Kontext | Bestimmte Gemini-Funktionen können den Navigationskontext nutzen |
| Gedächtnis/Personalisierung | Ja | Ja, je nach aktivierten Funktionen |
| Browser organisieren | Tab-Gruppierung/-Schließung | Ja im Rahmen agentischer Aufgaben |
| In einer Seite klicken | Nein | Ja |
| Formular ausfüllen | Nein | Ja |
| Bereits eingeloggte Sitzung nutzen | Nicht zum Handeln im Konto | Ja |
| Passwortmanager nutzen | Nein | Ja, mit Erlaubnis und ohne direkten Passwort-Offenlegung an das Modell |
| Multi-Site-Aufgabe abschließen | Im Wesentlichen Analyse und Planung | Ja |
| Jede sensible Aktion automatisch finalisieren | Nicht anwendbar | Nein: Bestimmte Schritte erfordern Bestätigung oder Übergabe |
Firefox baut also heute vor allem einen kontextbewussten Browser.
Google experimentiert bereits mit einem Browser, der die Autorität seines Nutzers ausüben kann.
Das ist ein viel tieferer Unterschied, als es scheint.
Das Passwort ist längst nicht mehr das eigentliche Privileg
Wenn es um KI-Zugriff auf unsere Konten geht, ist die reflexhafte Frage: „Kann sie mein Passwort sehen?“
Bei Chrome versichert Google: nein. Wenn auto browse den Google Password Manager nutzt, übernimmt der Manager die Authentifizierung, ohne das rohe Geheimnis an Gemini weiterzugeben.
Das ist wichtig.
Aber es verdeckt fast das interessantere Problem.
Angenommen, du bist bereits bei Gmail, Amazon, deiner Versicherung, deinem Mobilfunkanbieter oder einem Verwaltungsportal eingeloggt.
Der Browser behält dann üblicherweise Cookies, Session-Token und andere Authentifizierungszustände, die dem Dienst signalisieren: dieser Nutzer hat seine Identität bereits bewiesen.
Eine Software, die innerhalb dieser Sitzung handeln kann, braucht das Passwort nicht mehr zwingend.
Um den Einsatz zu verstehen, muss man das Geheimnis, das zur Erlangung einer Autorität dient, von der Autorität selbst unterscheiden.
Dein Passwort öffnet die Tür. Dein Session-Cookie beweist danach, dass die Tür bereits offen war.
Genau deshalb betrachtet Google einen kompromittierten Agenten, der in einem lokalen Chrome operiert, als Risiko für Datenlecks von bereits verbundenen Sites und baut neue Barrieren um diese Sitzungen herum.
Der Browser besitzt also etwas, das ein klassischer Chatbot fast nie hat: deine operationale Identität im Web.
Hier beginnt die Analogie zum Betriebssystem wirklich.
Der Browser besitzt bereits fast alle Primitiven, die ein Agent braucht
Ein klassisches Betriebssystem begnügt sich nicht damit, Fenster zu zeichnen.
Es stellt eine Umgebung bereit, die Programmen erlaubt, Ressourcen zu erhalten, Zustand zu bewahren, Berechtigungen anzufordern, mit anderen Diensten zu kommunizieren und mit bestimmten Privilegien zu handeln.
Für einen riesigen Teil unseres digitalen Lebens liefert der Browser nun das funktionale Äquivalent.
Die „Anwendung“ ist zur Webseite geworden. Der Ursprung example.com spielt beispielsweise die Rolle einer Sicherheitsgrenze. Cookies und Sitzungen tragen die Identität. Web-Speicher bewahrt den Zustand. Browser-APIs legen Standort, Kamera, Mikrofon oder Benachrichtigungen offen. Tabs kapseln verschiedene Kontexte. Der Passwortmanager fungiert als Tresor für Zugangsdaten.
Ein Agent, der über diesem Ensemble platziert wird, erhält dann drei wesentliche Dinge.
Er kann beobachten: Seiten, Tabs, manchmal einen Verlauf oder verbundene Dienste lesen.
Er kann über diese Umgebung nachdenken: „Ich muss drei Hotels finden, ihre Preise vergleichen, den Kalender prüfen und dann das Formular ausfüllen“.
Und vor allem kann er handeln: eine Seite öffnen, klicken, tippen, Informationen senden oder eine Operation auslösen.
Der Sprung zwischen den ersten beiden Fähigkeiten und der dritten ist enorm.
Ein Assistent, der sich bei der Zusammenfassung eines Hotels irrt, gibt dir eine schlechte Antwort.
Ein Agent, der sich bei der Nutzung dieses Hotels irrt, kann das falsche Zimmer buchen.
Genau das bezeichnet OWASP als excessive agency: Die Folgen eines Fehlers hängen nicht mehr nur davon ab, was das Modell schreibt, sondern von den Funktionen, Berechtigungen und Autonomiegraden, die ihm gewährt wurden.
Das Modell wird dann nur noch eine Sicherheitskomponente unter anderen.
Das wahre Produkt ist das System, das entscheidet, was er sehen und tun darf.
Prompt Injection ändert 완전히 die Schwere, wenn ein Modell klicken kann
Eine traditionelle Webseite mischt bereits Inhalte, die von mehreren Akteuren kontrolliert werden: Text des Herausgebers, Werbung, Kommentare, Iframes, Empfehlungen, Nutzerergebnisse.
Für dich ist ein Satz auf einer Seite normalerweise eine Information.
Für ein großes Sprachmodell kann ein Satz auch wie eine Anweisung aussehen.
Das ist der Kern der indirect prompt injection.
Eine Seite kann eine Anweisung enthalten, die nicht für den Menschen bestimmt ist, der sie liest, sondern für den Agenten, der sie analysiert.
Beispiel: das vorherige Ziel ignorieren, eine andere Site aufrufen, eine private Information abrufen oder bestimmte Daten senden.
Google nennt explizit Szenarien, in denen eine Injection versuchen würde, Informationen aus E-Mails oder Dokumenten zu extrahieren, Gmail-Nachrichten an einen externen Dienst weiterzuleiten oder Daten aus verbundenen Anwendungen preiszugeben.
Dieses Risiko ist nicht mehr rein theoretisch.
Im April 2026 hat Googles Sicherheitsteam das öffentliche Web über mehrere Common-Crawl-Snapshots analysiert und Injections gefunden, die auf Agenten abzielten: einige humorvoll, andere zur Manipulation von KI-SEO bestimmt, und eine geringere Zahl auf Exfiltration oder Datenvernichtung ausgerichtet. Zwischen November 2025 und Februar 2026 verzeichnete Google einen relativen Anstieg von 32 % der als bösartig eingestuften Kategorie. Das Unternehmen präzisiert jedoch, dass diese beobachteten Angriffegenerally wenig sophistiziert blieben und die Studie keine großen Teile sozialer Netzwerke abdeckte.
Die akademische Forschung zeigt parallel, warum es unvorsichtig wäre, zu erwarten, dass Modelle das Problem allein lösen.
Der Benchmark WASP testete verschiedene Web-Agent-Architekturen gegen realistische Injections. Je nach Konfiguration begannen Agenten, der feindlichen Anweisung in 16 bis 86 % der getesteten Fälle zu folgen. Sie erreichten das vollständige böswillige Ziel jedoch nur in 0 bis 17 % der Fälle, nicht zuletzt weil die Agenten selbst noch unvollkommen blieben. Diese Zahlen messen nicht Chrome auto browse, aber sie zeigen eine fundamentale Eigenschaft des Problems: Die Verbesserung der Handlungsfähigkeiten eines Agents kann auch Detouren ausnutzbar machen, die zuvor nur deshalb scheiterten, weil der Agent schlecht war.
Mit anderen Worten: Fortschritte bei der Zuverlässigkeit von Agenten sind gleichzeitig Fortschritte bei der Zuverlässigkeit für einen Angreifer, der sie erfolgreich umlenken würde.
Google erfindet gerade Sicherheitsprimitiven für dieses neue „OS“
Chromes Antwort auf das Problem ist besonders aufschlussreich.
Google versucht nicht nur, Gemini beizubringen, „nicht auf bösartige Seiten zu hören“.
Es fügt neue architektonische Barrieren um das Modell herum hinzu.
Eine davon ist der User Alignment Critic. Das Hauptmodell bereitet eine Aktion aus dem Webinhalt vor, den es konsultiert. Ein zweiter Komponente, der absichtlich vom nicht vertrauenswürdigen Webinhalt ferngehalten wird, erhält dann eine begrenzte Darstellung der geplanten Aktion und beurteilt, ob sie wirklich dem vom Nutzer gegebenen Ziel entspricht.
Die Idee ist wichtig: Nicht die der Angriff ausgesetzte Komponente soll auch ihr einziger Richter sein.
Chrome führt dann Agent Origin Sets ein.
Der Browser kennt seit langem das Konzept des Ursprungs: Zwei verschiedene Sites dürfen nicht frei auf die Daten der anderen zugreifen. Für seine Agenten erweitert Google diese Logik, indem er Ursprünge unterscheidet, die der Agent nur lesen darf, von denen, auf denen er auch handeln kann.
Eine irrelevante Seite kann so von dem ausgeschlossen werden, was das Modell sieht. Ein vom Agenten angeforderter neuer Ursprung muss kontrolliert werden. Google wendet auch deterministische Restriktionen auf vom Modell generierte URLs an, um bestimmte Exfiltrationsmechanismen zu begrenzen.
Das ist nicht mehr bloß „AI Safety“.
Das ist Kapazitätskontrolle.
Und es ähnelt stark den Problemen, die Betriebssysteme seit Jahrzehnten zu lösen versuchen: Welcher Prozess darf auf welche Ressource zugreifen, mit welcher Berechtigung, wie lange und für welche Operation?
Der Parallelismus wird noch deutlicher bei sensiblen Aktionen.
Chrome vorsieht Bestätigungen oder Übergaben für bestimmte Operationen: Navigation zu sehr sensiblen Site-Kategorien, Authentifizierung via Password Manager, Käufe, Zahlungen, Versand von Nachrichten oder andere Aktionen mit hohen Konsequenzen. Der Nutzer kann auch das Arbeitsprotokoll einsehen und den Agenten stoppen.
Das alte Modell war:
Site → fordert Berechtigung an → Nutzer akzeptiert oder verweigert.
Der Agent führt ein schwierigeres Modell ein:
Nutzer → äußert Absicht → Agent interpretiert Absicht → entdeckt Sites → ruft Daten ab → wählt Aktionen → Browser muss entscheiden, welche der ursprünglichen Absicht entsprechen.
Die Berechtigung betrifft also nicht mehr nur eine Ressource.
Sie betrifft den Sinn einer Aktion.
Und eine Maschine muss nun diesen Sinn überprüfen.
Firefox verkleinert das Problem, indem es die Autorität weiter verweigert
Mozillas aktuelle Strategie ist fast das Gegenteil.
Smart Window profitiert von einer Menge Kontext, die vor wenigen Jahren noch extraordinär invasiv für einen in den Browser integrierten Chatbot erschienen wäre, aber der Assistent verfügt über sehr wenige Handlungsfähigkeiten.
Er kann die aktuelle Seite, explizit hinzugefügte Tabs und bestimmte Verlaufsinformationen nutzen, wenn eine Anfrage dies erfordert. Er kann auch „Memories“ aus der Browser-Aktivität und den Gesprächen erzeugen, wenn der Nutzer diese Funktion aktiviert.
Bei der Initialisierung gibt Mozilla an, dass bis zu 60 Tage oder 3.000 Verlaufeinträge, je nachdem, was zuerst erreicht wird, verarbeitet werden können, um diese Erinnerungen zu generieren. Die Daten durchlaufen vorübergehend Mozillas Server, aber die gewonnenen Erinnerungen werden dann lokal gespeichert; Mozilla versichert, diese Daten nach der Verarbeitung nicht aufzubewahren.
Das stellt dennoch einen großen Wandel für Firefox dar.
Ein klassischer Browser erinnert sich hauptsächlich wo du warst.
Ein Browser mit Gedächtnis versucht abzuleiten, was dich interessiert, aus diesen Bewegungen.
Mozilla fügt Filter hinzu, um bestimmte Erinnerungen insbesondere im Gesundheits-, Finanz- oder Rechtsbereich zu vermeiden, erlaubt deren Löschung und schließt private Fenster aus. Smart Window kann sogar einen mit der OpenAI-API kompatiblen Endpoint nutzen, den der Nutzer wählt, einschließlich eines lokalen Modells.
Aber die effektivste Verteidigung bleibt heute extrem einfach:
Smart Window kann nicht in Seiten handeln.
Eine Injection, die einen Produktvergleich beeinflusst, ist ein Problem der Informationsintegrität.
Eine Injection, die einen Agenten steuert, der Zugriff auf Gmail, ein Händlerkonto und ein Formular hat, wird potenziell zu einem Problem der Vertraulichkeit und Integrität der Konten.
Mozilla erkennt das Risiko von Prompt Injection dennoch explizit an und gibt an, unter anderem eine Trennung zwischen Daten und Anweisungen sowie Aktionsbeschränkungen einzusetzen, wenn das System nicht vertrauenswürdige Inhalte verarbeitet.
Das deutet darauf hin, dass Firefox bereits Fundamente für eine agentischere Architektur legt.
Aber heute ist der philosophische Unterschied klar: Mozilla reichern zuerst den Kontext an; Google erweitert bereits die Autorität.
Agenten-Berechtigungen riskieren, viel schwerer verständlich zu sein als App-Berechtigungen
Auf dem Smartphone kann eine Berechtigung relativ verständlich sein.
„Zugang zur Kamera erlauben?“
Die Ressource ist klar.
Für einen Agenten könnte das Äquivalent werden:
„Gemini erlauben, diese Aufgabe auszuführen?“
Aber was bedeutet genau diese Aufgabe?
Wenn du „organisiere meine Reise“ fragst, darf der Agent dann eine E-Mail mit Konferenzzeiten lesen? Deinen Kalender konsultieren? Deinen Standort nutzen? Deinen Namen an ein Hotel übermitteln? Deine Treuenummer eingeben? Eine Site öffnen, die nicht geplant war, als du die Aufgabe gestartet hast?
Jeder Schritt kann für sich genommen vollkommen vernünftig sein.
Die Gefahr liegt in ihrer Komposition.
Das ist eine der beunruhigendsten Eigenschaften von Agenten: gutartige Berechtigungen können zusammen eine extrem mächtige Fähigkeit bilden.
Kalenderzugriff + Gmail + authentifizierter Browser + Formulare + Verlauf + Passwortmanager bedeutet nicht einfach „sechs Funktionen“.
Das bedeutet potenziell eine Software, die weiß, wohin du musst, eine Buchung wiederfindet, sich beim Anbieter einloggt, diese ändert und jemanden über die Änderung informiert.
Der Browser wird dann zu einem Autoritäts-Makler.
Und ständige Bestätigungen sind keine perfekte Lösung. Je mehr das System die Zustimmung des Nutzers einfordert, desto weniger autonom ist es; je mehr es diese Unterbrechungen maskiert, desto höher das Risiko unerwünschter Aktionen.
Das ist ein struktureller Kompromiss, kein vorübergehender Interface-Bug.
Identität wird zu einer eigenständigen Angriffsfläche
Browser-Agenten schaffen auch eine neue Unterscheidung zwischen „privaten Daten“ und „Fähigkeit, als du zu handeln“.
Das ist nicht dasselbe.
Ein Angreifer, der eine Datei stiehlt, erhält ein Datum.
Ein umgelenkter Agent, der in einer authentifizierten Sitzung handelt, kann potenziell etwas Nützlicheres erhalten: die Möglichkeit, den Dienst aufzufordern, eine Operation im Namen des Nutzers auszuführen.
Das ist das klassische confused deputy-Problem, angewandt auf Agenten: Eine legitime Komponente besitzt Privilegien, aber ein anderer Akteur schafft es, die Art und Weise zu beeinflussen, wie sie ausgeübt werden.
Der Angreifer muss dann deine Identität nicht direkt stehlen.
Er versucht, die Software, die bereits diese Identität besitzt, zu überzeugen, sie für ihn zu nutzen.
Chromes Verteidigungen um die Ursprünge nehmen hier ihren vollen Sinn. Indem Google begrenzt, was der Agent lesen kann und auf welchen Sites er schreiben kann, versucht es, die Menge an ambianter Autorität zu reduzieren, die während einer Aufgabe verfügbar ist.
Dieses Prinzip könnte für Agenten so fundamental werden wie die Sandbox für klassische Browser.
Der Browser ersetzt doch nicht wirklich das Betriebssystem
Die Analogie hat ihre Grenzen.
Chrome oder Firefox kontrollieren nicht direkt Prozessor, physischen Speicher, Treiber, Systemdateien oder Hardware-Isolation. Sie verlassen sich weiterhin auf die Mechanismen von Windows, macOS, Linux, Android oder iOS.
Agenten können außerdem über dem Betriebssystem selbst funktionieren, APIs direkt nutzen oder in entfernten virtuellen Maschinen ohne grafische Oberfläche arbeiten.
Zu sagen, der Browser „werde zum neuen OS“ im wörtlichen Sinne wäre also übertrieben.
Eine präzisere Formulierung wäre:
Der Browser wird das Betriebssystem unserer Web-Identität.
Er ist bereits der Ort, an dem ein großer Teil unserer Anwendungen, Sitzungen und Kommunikation koexistiert. Der Agent fügt das fehlende Stück hinzu: einen kognitiven Ordonnanzeur, der ein abstraktes Ziel entgegennehmen und entscheiden kann, welche Web-Anwendungen mobilisiert werden, um es zu erreichen.
Der Mensch hört auf, die Abfolge von Aktionen zu liefern.
Er liefert die Absicht.
Die fundamentale Einheit des Webs könnte vom Klick zur Absicht wechseln
Seit drei Jahrzehnten ruht ein großer Teil der Web-Sicherheit auf einer stillen Hypothese: Der Nutzer ist der, der klickt.
Eine Site kann den Nutzer täuschen. Eine Extension kann den Browser umleiten. Ein Script kann eine Verwundbarkeit ausnutzen.
Aber der Browser selbst entschied normalerweise nicht, dass ein Knopf gedrückt werden sollte, weil er ungefähr deinem Ziel entspricht.
Agenten ändern diese Hypothese.
Wenn du „verlängere mein Abo, aber find mir eine günstigere Formel“ fragst, muss das System interpretieren, was „günstiger“ bedeutet, bestimmen, welche Site zu nutzen ist, deren Interface verstehen, auf das passende Konto zugreifen, die Konsequenzen identifizieren und wissen, wann deine Zustimmung unverzichtbar wird.
Der Browser transportiert nicht mehr einfach menschliche Absichten, die durch Klicks ausgedrückt werden.
Er beginnt, sie in Aktionen zu kompilieren.
Und das bringt ein neues, extraordinär schwieriges Sicherheitsproblem zum Vorschein.
Für einen traditionellen Browser musste man insbesondere bestimmen:
hat diese Site das Recht, auf dieses Datum zuzugreifen?
Für einen agentischen Browser wird die Frage:
entspricht diese Aktion wirklich dem, was der Mensch wollte, trotz allem, was der Agent gerade im Web gelesen hat?
Chrome beginnt, spezifische Mechanismen zu schaffen, um diese Frage zu beantworten. Firefox vermeidet vorerst weitgehend, sie stellen zu müssen, indem er seinen Assistenten auf der Seite der Beobachtung statt der Ausführung hält.
Aber die allgemeine Richtung ist schwer zu übersehen.
Der Browser war die Software, in der wir das Internet nutzten.
Er wird allmählich die Software, der wir das Internet anvertrauen, es an unserer Stelle zu nutzen.