Implantate beginnen, die innere Sprache zu decodieren. Die eigentliche Grenze wird die Einwilligung
Fast zeitgleich veröffentlichte Fortschritte zeigen Brain-Computer-Interfaces, die Sprache, Gesten und sogar imaginierte Sprache wiederherstellen können. Ihr nächstes Problem wird vielleicht nicht mehr sein, mehr zu decodieren, sondern zu wissen, wann man nicht zuhören soll.
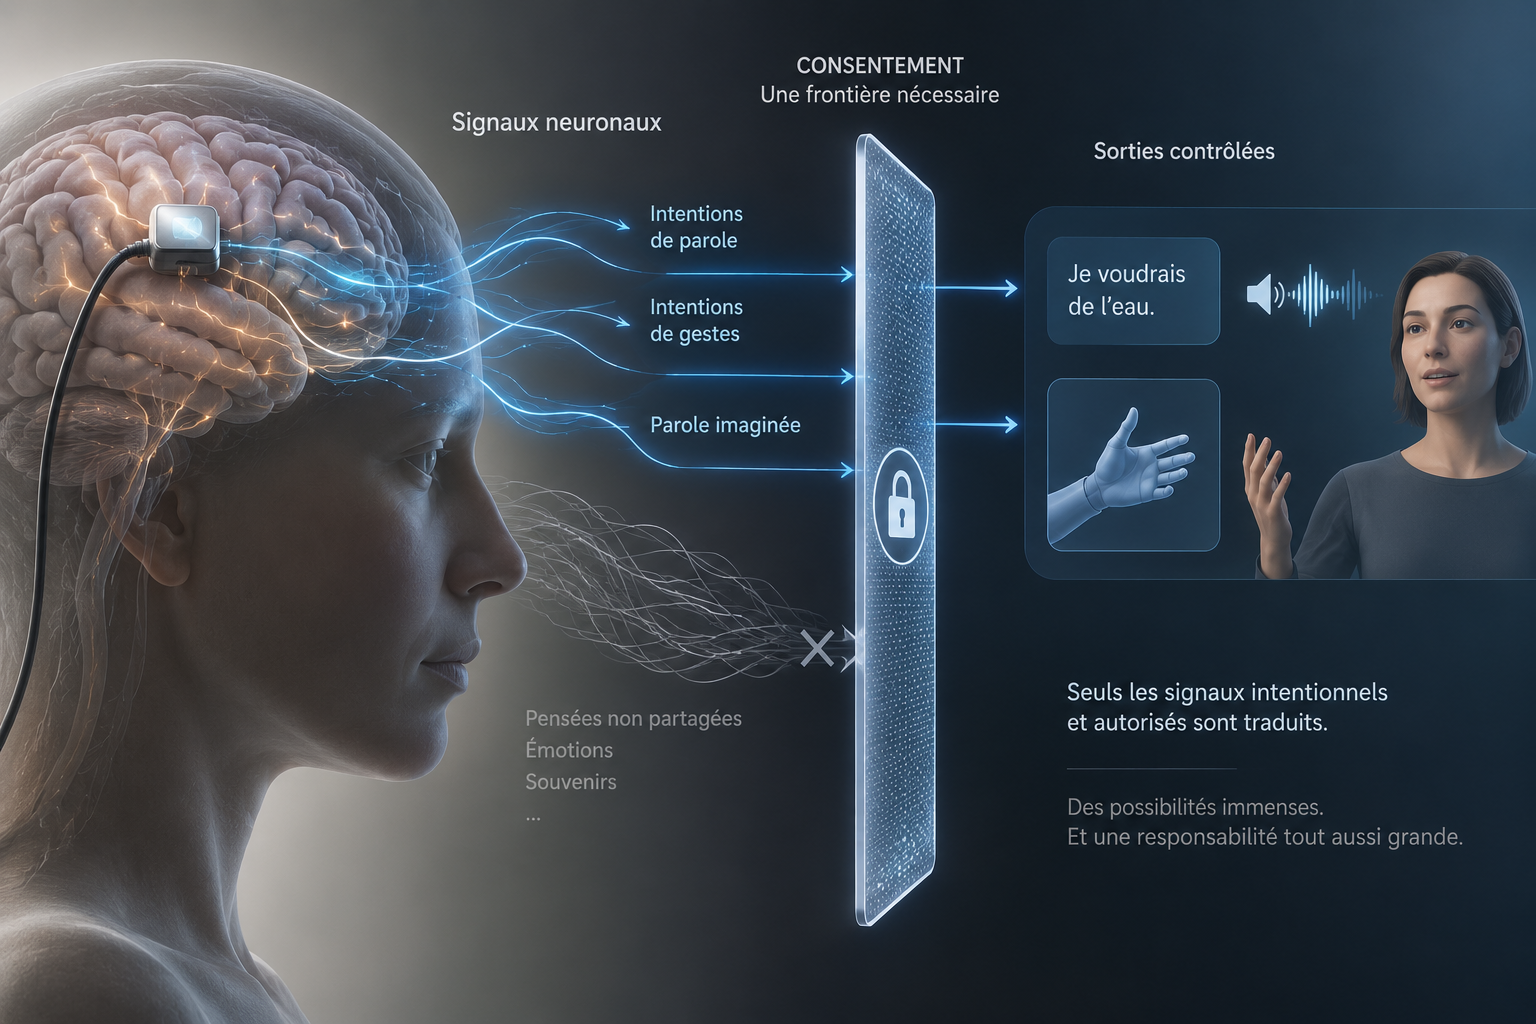
Am 14. September 2026 haben sich zwei verschiedene Geschichten über Brain-Computer-Interfaces überlagert.
An der UCSF veröffentlichten Forscher die erste Demonstration eines kortikalen Implantats, das gleichzeitig Sprache und Gesten decodieren kann, um einen Avatar zu animieren.
Am selben Tag enthüllte Paradromics, dass die erste Teilnehmerin seines Langzeitversuchs mithilfe ihres Implantats Gespräche führen konnte, einschließlich dann, wenn sie lediglich sprach, ohne es physisch zu tun.
Getrennt betrachtet sind es zwei technische Fortschritte.
Nebeneinander gestellt mit den jüngsten Arbeiten zur inneren Sprache kündigen sie etwas Tieferes an: Wir werden schrittweise gezwungen, technologisch die Grenze zwischen einem Gedanken, der bestimmt ist, Kommunikation zu werden, und einem Gedanken, der bestimmt ist, privat zu bleiben zu definieren.
Ein einzelnes Implantat, um mehr als eine Stimme wiederzugewinnen
Die UCSF-Studie, veröffentlicht in Nature Neuroscience, betrifft drei Personen mit schwerer Lähmung, die hochdichte ECoG-Implantate auf der Oberfläche des sensomotorischen Kortex nutzen.
Kommunikations-BCIs hatten bishermostly separate Fähigkeiten behandelt: den Versuch zu sprechen zu decodieren, einen Cursor zu bewegen, eine Bewegung zu erkennen.
Doch ein Mensch kommuniziert nicht wie ein Dialogfeld.
Wir sprechen, während wir nicken. Wir betonen mit den Händen. Wir verweigern durch eine Geste. Ein körperlicher Ausdruck kann einen Satz ergänzen, widersprechen oder ersetzen.
Das Team von Edward Chang hat daher versucht, diese Verhaltensweisen parallel zu decodieren.
Zwei Teilnehmer steuerten einen personalisierten Avatar, der Text entsprechend der decodierten Sprache anzeigen konnte, während er Gesten aus der Gehirnaktivität reproduzierte.
Das wirkt fast offensichtlich, sobald es realisiert ist.
Für das Gehirn war es das keineswegs.
Sprechen und eine Geste machen ist nicht die Addition zweier unabhängiger Signale
Die zerebralen Repräsentationen, die für Sprache und Körperbewegungen genutzt werden, sind nicht perfekt isoliert.
Die Forscher beobachteten teilweise überlappende Aktivitätszonen. Vor allem funktionierten Modelle, die nur trainiert wurden, wenn die Teilnehmer entweder sprachen oder eine Geste machten, weniger gut, wenn beide Verhaltensweisen simultan versucht wurden.
Mit anderen Worten:
“Sprache + Geste” ist nicht genau gleich “Sprachsignal + Gestensignal”.
Der Kontext ändert die Repräsentation.
Das Team erzielte bessere Ergebnisse, indem es dem Modell Beispiele isolierter und simultaner Verhaltensweisen gab und es zusätzlich lernte, zu erkennen, wann die andere Modalität inaktiv bleiben musste.
Diese Beobachtung geht über dieses spezielle Experiment hinaus.
Eine zukünftige generalistische Gehirn-Schnittstelle wird wahrscheinlich nicht als Sammlung kleiner, perfekt unabhängiger Decoder gebaut werden können – einer fürs Sprechen, einer fürs Handbewegen, einer für die Maussteuerung.
Das Gehirn wurde nicht organisiert, um unsere Software-Architekturen zu vereinfachen.
Nein, das Implantat hat nicht einfach “100 % Genauigkeit erreicht”
Eine Teilnehmerin, Bravo-1r, erreichte tatsächlich eine median Genauigkeit von 100 % für Sprache und Gesten während drei konversationeller Blöcke.
Aber ihr experimenteller Wortschatz umfasste nur fünf gesprochene Ausdrücke und vier Gesten.
Für Bravo-6, der mit zehn Sätzen, zehn Gesten und bis zu hundert Sprache-Geste-Kombinationen arbeitete, erreichte das Echtzeit-Gespräch im Durchschnitt 75 % für Sprache und 85 % für Gesten.
Diese Ergebnisse sind bemerkenswert.
Sie bedeuten nicht, dass ein Implantat nun alle menschlichen Sätze und Bewegungen mit perfekter Genauigkeit versteht.
Die Studie selbst beschreibt einen Proof of Concept, mit kleinen Befehlssätzen, insgesamt drei Teilnehmern und weitgehend individualisierten Modellen. Die Autoren nennen weiterhin Wortschatzgröße, Latenz, Generalisierung und die Notwendigkeit von Studien mit mehr Patienten als nächste Herausforderungen.
Gerade weil die reale Technologie bereits beeindruckend ist, muss sie nicht übertrieben werden.
Paradromics greift ein anderes Stück des Problems an
Der Ansatz von Paradromics ist anders.
Im Juni 2026 implantierten das Unternehmen und die Universität Michigan dauerhaft das erste Connexus-System im Rahmen der von der FDA zugelassenen klinischen Connect-One-Studie.
Das Implantat nutzt ein hochdichtes intrakortikales Array. Die Signale werden zu einem im Brustbereich implantierten Transceiver geleitet, bevor sie drahtlos durch die Haut zu einem externen Empfänger übertragen werden.
Das ist ein großer praktischer Unterschied.
Eine BCI, die ein Alltagsgerät werden soll, kann nicht ewig von einem laborvoller Kabel abhängen.
Die FDA hat Paradromics am 26. August übrigens autorisiert, die Verbindung seines Systems mit kompatiblen Laptops, Tablets und persönlichen Telefonen vorzubereiten, statt es auf eine vom Unternehmen bereitgestellte Rechenumgebung zu beschränken.
Das Ziel beginnt, weniger wie ein Experiment und mehr wie eine neue Computereingabeebene auszusehen.
Dann kommt die imaginierte Sprache
Die erste Teilnehmerin der Connect-One-Studie ist eine Frau mit einer Motoneuronerkrankung, die ihr Sprechen extrem erschwert.
Paradromics behauptet, ihr Implantat habe es ihr ermöglicht, Text und synthetische Sprache bei spontanen Echtzeit-Gesprächen zu produzieren.
Noch bemerkenswerter: Das System gelangte auch dazu, Sprache zu produzieren, wenn sie sich vorstellte, was sie sagen wollte, ohne physisch zu versuchen zu sprechen. Die Ergebnisse waren etwas weniger klar als bei Sprechversuchen oder Flüstern.
Hier muss sofort eine wissenschaftliche Grenze gezogen werden.
Diese Leistungen wurden von Paradromics angekündigt und aus seiner klinischen Studie berichtet. Sie haben noch keine vergleichbare, peer-reviewte Veröffentlichung wie die UCSF-Studie erfahren.
Der Beweisstatus ist also nicht derselbe.
Aber die technologische Richtung ist glaubwürdig, weil Paradromics nicht in ein wissenschaftliches Vakuum tritt.
Die innere Sprache war bereits decodierbar
2025 hatte eine in Cell veröffentlichte Studie dieses Problem direkt an vier mit BCI ausgestatteten Teilnehmern untersucht.
Die Forscher stellten fest, dass innere Sprache – das mentale Aussprechen etwas, ohne zu versuchen, es zu artikulieren – stark im Motorkortex repräsentiert war.
Imaginierte Sätze konnten in Echtzeit decodiert werden. Noch beunruhigender: Bestimmte Elemente innerer Sprache konnten auch in Aufgaben wiederhergestellt werden, in denen die Teilnehmer nicht explizit angewiesen waren zu kommunizieren, wie beim Zählen oder Abrufen von Sequenzen.
Wir sind noch extrem weit von einer Maschine entfernt, die willkürlich in alles hineinschnüffeln kann, was jemand denkt.
Aber dieses Experiment zerstört bereits eine beruhigende Hypothese:
**“Wenn ich nicht versuche zu kommunizieren, kann der Decoder nichts Auswertbares erfassen.” **
Das ist nicht mehr ganz wahr.
Man muss aufhören, von “Gedankenlesen” zu sprechen
Der Begriff ist verführerisch und wissenschaftlich mittelmäßig.
Eine BCI empfängt keinen abstrakten Satz, der irgendwo im Gehirn schweben würde.
Sie misst Muster neuronaler Aktivität und lernt ihre statistischen Beziehungen zu sorgfältig definierten Verhaltensweisen oder Zuständen: Artikulationsversuch, innere Sprache, motorische Absicht, imaginierte Bewegung.
Sie muss kalibriert werden. Sie macht Fehler. Die Leistungen variieren zwischen Personen. Die experimentellen Wortschätze bleiben begrenzt.
Sie kann dein Gehirn nicht wie eine Akte öffnen und suchen:
“Bankpasswort”
oder:
“peinliche Erinnerung von 2017”.
Die richtige Frage ist also nicht:
“Kann man alle Gedanken lesen?”
Sondern:
“Welcher Satz kognitiver Zustände wird hinreichend beobachtbar, damit ein Computer darauf handeln kann?”
Diese Formulierung ist weniger spektakulär.
Sie ist viel wichtiger.
Das zukünftige Problem wird sein, vier Dinge zu unterscheiden
Je mehr diese Systeme fortschreiten, desto mehr können vier Zustände technologisch benachbart werden, während sie menschlich radikal verschieden sind:
- Ich versuche physisch, einen Satz auszusprechen;
- Ich bilde mir diesen Satz freiwillig ein, um ihn an die BCI zu übertragen;
- Ich spreche innerlich mit mir selbst, ohne kommunizieren zu wollen;
- Ich höre jemandem zu, der spricht.
Für einen Algorithmus erzeugen diese Zustände Signale mit gewissen gemeinsamen Beziehungen.
Für uns entspricht der Unterschied schlicht der Absicht und der Einwilligung.
Eine hinreichend sensible Schnittstelle, die den zweiten Zustand decodieren kann, muss daher so entworfen sein, dass sie den dritten nicht mit ihm verwechselt.
Und Forscher arbeiten bereits an dieser Frage.
Das erste “mentale Passwort” existiert bereits
Die Cell-Studie von 2025 testete eine überraschend elegante Lösung.
Die Forscher trainierten das System, das Decodieren innerer Sprache nur nach Erkennung eines freiwillig vom Nutzer gedachten Schlüsselworts zu aktivieren.
Für das Experiment wählten sie einen phonetisch ungewöhnlichen Ausdruck, damit er selten zufällig erscheint. Der Mechanismus erlaubte, den Decoder zu verriegeln, solange der Nutzer nicht explizit seine Absicht signalisiert hatte, innerlich zur Maschine zu sprechen.
Das ist noch eine experimentelle Demonstration.
Aber philosophisch ist sie faszinierend.
Wir bauen bereits das neuronale Äquivalent von:
“Hey Siri”.
Nur dass man es nicht mehr aussprechen muss.
Eine BCI sollte vielleicht nicht versuchen, das Gehirn maximal zu verstehen
Die Geschichte der Informatik hat uns an eine simple Idee gewöhnt: Je mehr Daten ein Sensor sammelt, desto besser.
Für eine Gehirn-Schnittstelle wird dieses Prinzip gefährlich.
Das beste System wird nicht notwendigerweise das sein, das die maximale Menge neuronaler Information extrahiert.
Es wird drei verschiedene Fähigkeiten besitzen müssen:
zu verstehen, was ich ausdrücken will;
zu wissen, wann ich es ausdrücken will;
alles andere korrekt zu ignorieren.
Die dritte könnte genauso wichtig werden wie die ersten beiden.
Denn neuronale Vertraulichkeit wird nicht allein von einem vertraglichen Versprechen abhängen können, wonach ein Unternehmen bestimmte Signale nicht nutzen wird.
Der robusteste Schutz besteht darin, technisch zu verhindern, dass diese Signale zu auswertbaren Ausgängen werden, wenn der Nutzer es nicht verlangt hat.
Das ist eine neue Art, Privatsphäre zu denken:
Nicht mehr nur zu kontrollieren, wer die Daten nach ihrer Erstellung lesen kann, sondern zu kontrollieren, welche kognitiven Daten erst überhaupt computergestützt werden.
BCIs beginnen, Menschen, die ihre Stimme verloren haben, diese zurückzugeben. Sie beginnen, ihre Gesten wiederherzustellen. Sie könnten eines Tages zu generellen Schnittstellen mit unseren Geräten werden.
Ihr Erfolg wird sich jedoch nicht nur daran messen, was sie alles zu hören fähig sein werden.
Die beste Brain-Computer-Interface könnte die sein, die weiß, wann sie schweigen muss.